TL;DR ⏩
- Zbieraj wszystko w jednym miejscu. Wywiady, rozmowy discovery i rozmowy z odchodzącymi klientami trafiają do HappyScribe przez AI notetakera, aplikację mobilną, wgrywanie plików albo import z linku
- Porządkuj w folderach. Sortuj transkrypcje według projektu, segmentu albo obszaru produktu, żeby wskazać Claude jeden konkretny zestaw materiałów
- Podłącz konektor HappyScribe do Claude. Zadawaj pytania obejmujące wiele folderów, żeby znaleźć wzorce, porównać grupy klientów i zweryfikować hipotezy na podstawie wywiadów
- Trzymaj dowody przy wnioskach. Claude zwraca cytaty ze znacznikami czasu, więc każdy wątek da się prześledzić do źródła, zanim trafi do gotowego materiału
„Mam wszystkie rozmowy z klientami i wnioski sprzed miesięcy na wyciągnięcie ręki” — nie powiedział nigdy żaden badacz.
Wiesz, że feedback od klientów gdzieś jest. Ale uporządkowanie danych z zeszłego kwartału i pokazanie ich w minutę to droga przez mękę.
Prawie połowa badaczy (49%) przyznała w badaniu User Interviews, że pesymistycznie patrzy na przyszłość badań UX — to skok o 26 punktów w ciągu jednego roku. Jednocześnie 80% z nich korzysta już z AI na jakimś etapie pracy badawczej.
Przy tylu zmianach w branży nie chcesz stracić dowodów, na które już ciężko zapracowałeś.
Rozwiązanie jest takie: zbuduj repozytorium badań klientów w HappyScribe, a potem nałóż na nie Claude. Na papierze to mało oczywisty duet, ale dla badaczy i agencji działa znakomicie.
Co to właściwie jest repozytorium badań klientów
Repozytorium badań klientów to centralne miejsce z dowodami od klientów, które przeżywa projekt, z którego pochodzą. To nie jest prezentacja ani podsumowanie spisane przez kogoś na spotkaniu — w środku są prawdziwe rozmowy.
To, co większość zespołów nazywa repozytorium, jest folderem z raportami z badań, a raport to już przefiltrowana, subiektywna interpretacja. Powstaje pod konkretny projekt i nie sprawdza się jako jedno źródło prawdy o kliencie.
Co powinno znaleźć się w repozytorium badań:
- Wywiady z klientami i użytkownikami
- Sesje testów użyteczności
- Rozmowy discovery i notatki ze spotkań sprzedażowych
- Wywiady z klientami, którzy odeszli lub zrezygnowali
- Rozmowy doradcze z klientami
- Rozmowy onboardingowe, na których uczestnicy badania powiedzieli coś wartościowego
Transkrypcja jest tym, co sprawia, że to wszystko działa. Kiedy dokładnie nagrywasz i zamieniasz audio oraz wideo na tekst, możesz wyszukiwać słowa kluczowe ze znacznikami czasu w interaktywnej transkrypcji. Dowody z wielu źródeł zostają w zasięgu ręki jeszcze wiele miesięcy po zamknięciu badania.
Dlaczego sam folder z transkrypcjami i sam Claude to za mało
Już teraz możesz wkleić transkrypcję spotkania do Claude i dostać sensowną analizę. Przy jednym wywiadzie sprawdzi się to bez problemu, ale wyobraź sobie przerabianie 20 wywiadów nagranych przez 3 miesiące!
Ręczny proces wygląda tak: znajdź plik > wgraj go > wyjaśnij kontekst badania > uruchom analizę > powtórz następnym razem. Claude Projects rozwiązuje część tego problemu.
Potrzebne pliki wgrywasz raz jako wiedzę projektu, a instrukcje własne przenoszą założenia twojego badania do każdej nowej rozmowy. Każdy czat startuje z już wczytanym kontekstem, więc nie musisz od nowa tłumaczyć tej samej historii.
Czego Claude Projects nie rozwiąże, to skala. Claude dobrze radzi sobie z kilkoma transkrypcjami wywiadów, zanim zapełni się okno kontekstowe, ale repozytorium ma rosnąć znacznie dalej.
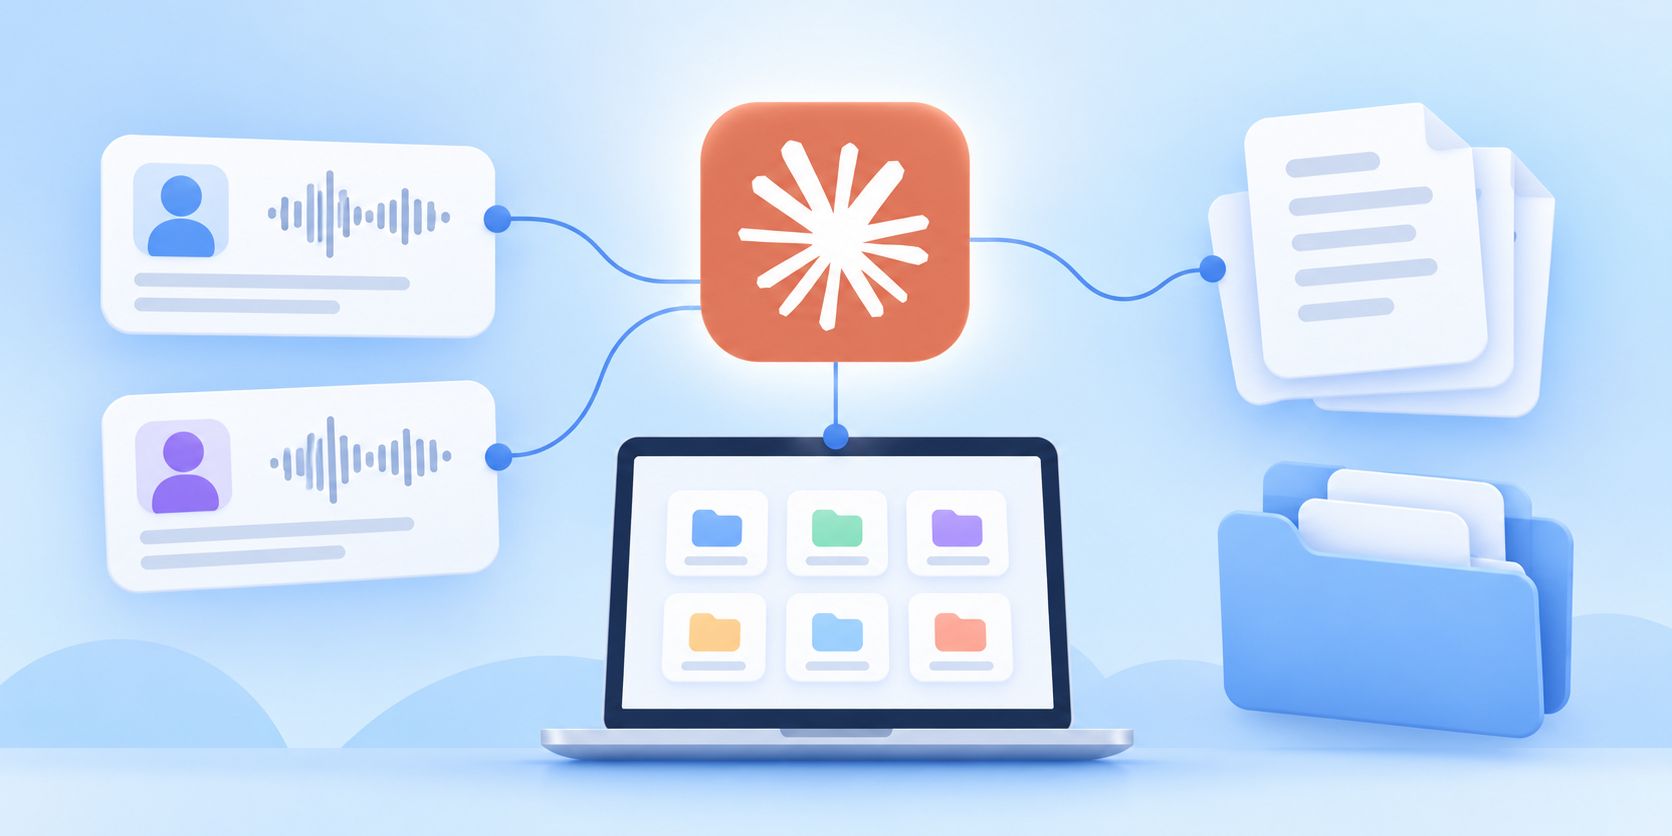
Od tego jest Model Context Protocol. Połączenie MCP spina twoje repozytorium badań bezpośrednio z Claude, dzięki czemu sięga on po transkrypcje tam, gdzie już są.
Konektory Claude działają w oparciu o ten standard — i za chwilę pokażę ci, jak to ustawić.
Krok 1: Zbierz wszystkie rozmowy z klientami w jednym miejscu
Zanim Claude na coś się przyda, rozmowy muszą gdzieś istnieć w formie tekstu. HappyScribe robi to na cztery sposoby, zależnie od tego, jak prowadzisz badania.
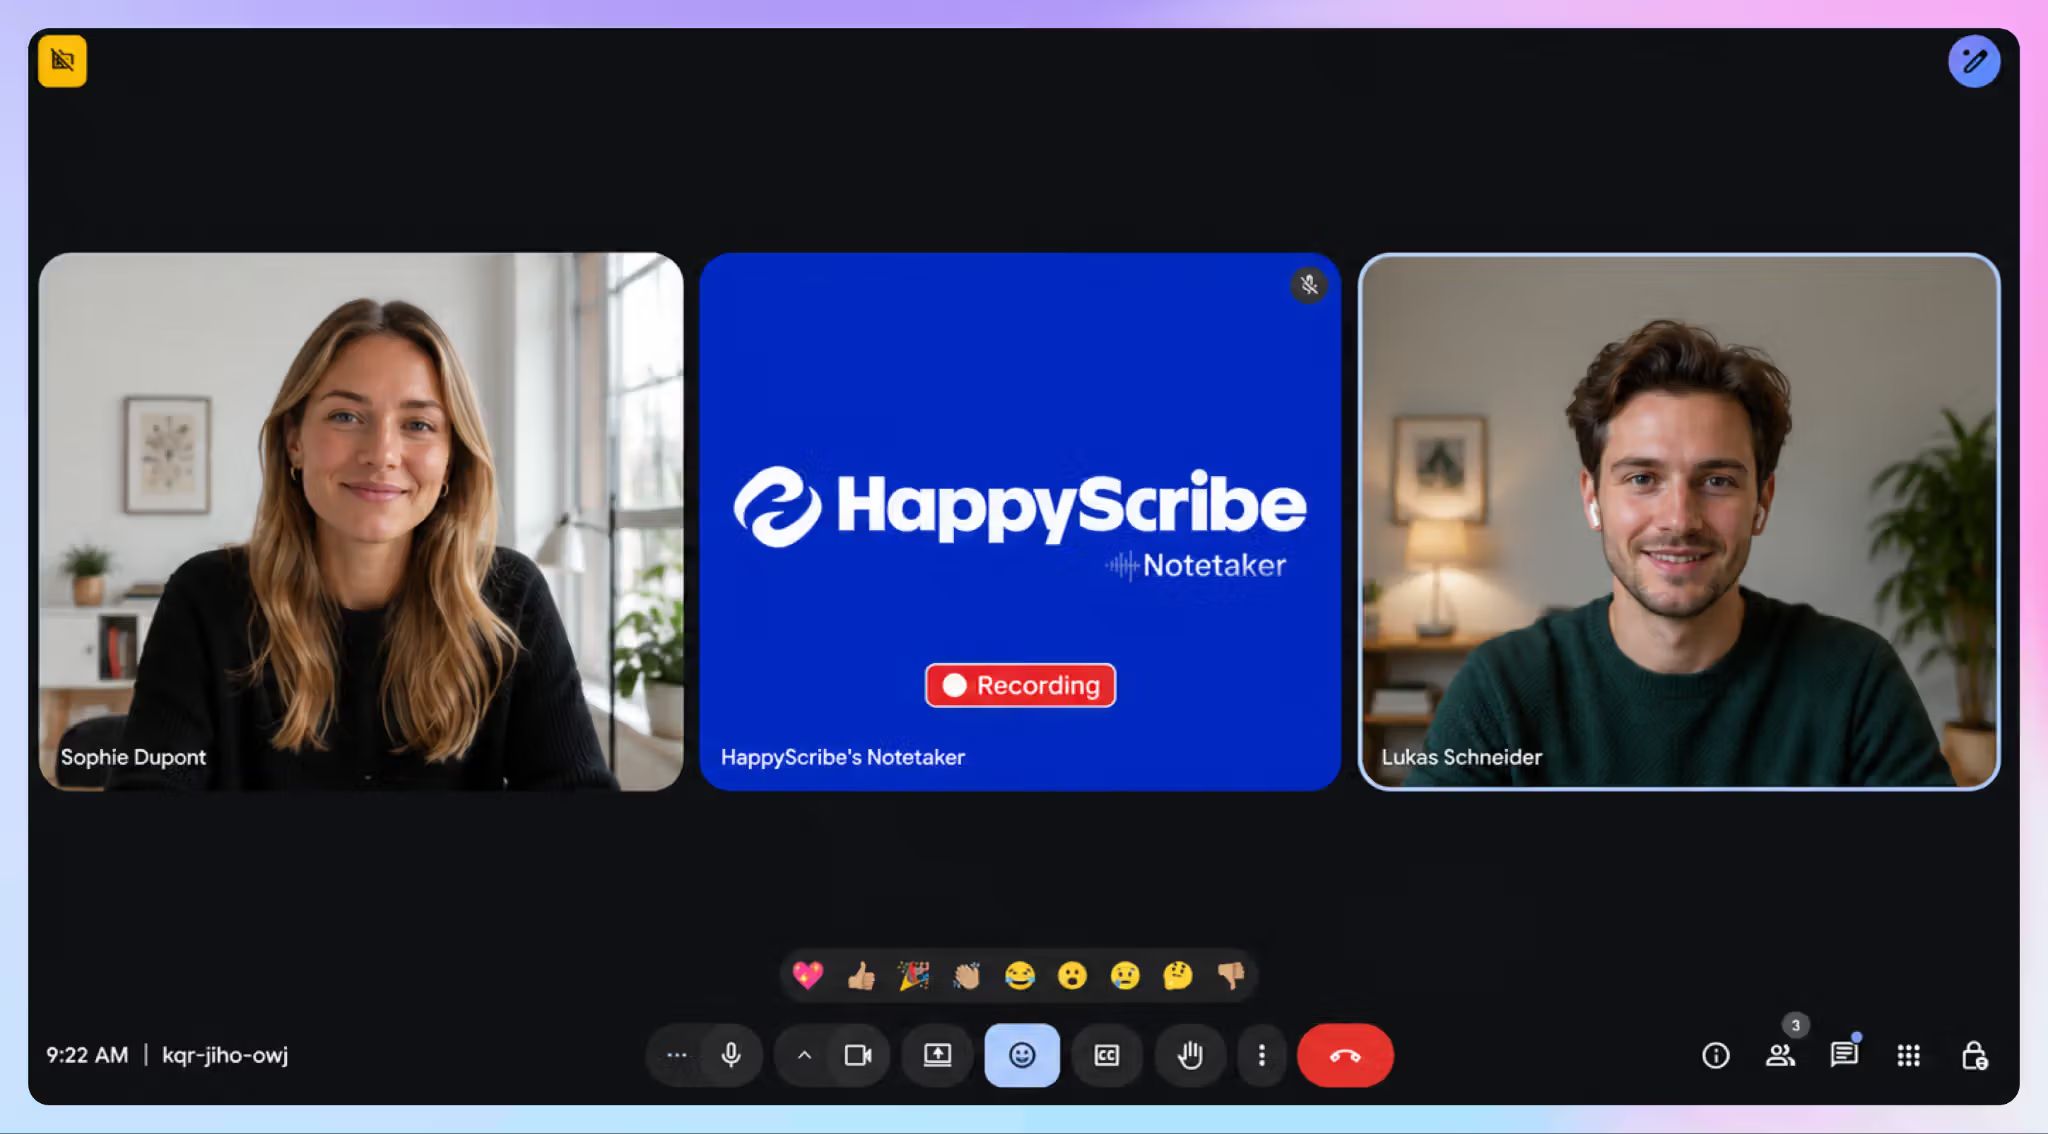
1. Przy spotkaniach zdalnych podłącz kalendarz, a AI notetaker do spotkań dołączy do zaplanowanych rozmów w Zoom, Google Meet czy Microsoft Teams. Sam nagra, przepisze i uporządkuje wynik.
2. Przy pracy na miejscu albo spontanicznych rozmowach nagrywaj prosto z aplikacji mobilnej HappyScribe. Wszystkie wizyty terenowe i badania kontekstowe wylądują na tym samym koncie co rozmowy zdalne.
3. Zaległości nadrób, wgrywając to, co już masz. Nowe repozytorium szybko wzbogacisz archiwalnymi nagraniami wywiadów — i zwykle właśnie od tego zaczynają agencje.
4. Możesz też importować z Google Drive, Box, Wistia, Dropbox, YouTube i Vimeo, co obejmuje nagrane webinary i wszystko, co przyśle klient.
HappyScribe obsługuje ponad 150 języków i dialektów, a automatyczną transkrypcję można podnieść do poziomu transkrypcji weryfikowanej przez człowieka, gdy dokładność wymaga oka eksperta.
Sens tego kroku jest prosty: przestań pozwalać, żeby dowody od klientów leżały w oderwanych od siebie miejscach.
Krok 2: Uporządkuj materiały pod pytania, które zadasz później
Masz już stos transkrypcji w jednym miejscu, ale dotyczą różnych projektów, celów i działów. Kolejny krok to rozłożenie ich do folderów, żeby wskazywać Claude konkretny zestaw materiałów zamiast całego konta. Foldery są też po prostu przyjemniejsze dla oka.
Tak możesz poukładać transkrypcje w folderach w HappyScribe:
- Według projektu badawczego. Badania onboardingu, analiza cen, wywiady z odchodzącymi klientami, rundy discovery w segmencie enterprise itd. To odpowiada temu, jak praca faktycznie jest zlecana.
- Według segmentu klientów. SMB, mid-market, enterprise, uczelnie, ochrona zdrowia itd. Przydaje się, gdy wiesz, że będziesz później porównywać grupy.
- Według obszaru produktu. Aktywacja, współpraca, raportowanie, płatności, wyszukiwanie — albo cokolwiek innego, wokół czego zbudowana jest twoja roadmapa. Ta struktura najlepiej służy product managerom, gdy przychodzą z pytaniami po miesiącach.
- Według okresu. Kwartały albo rundy badań, żeby zobaczyć, jak ten sam wzorzec przesuwa się między jedną rundą a kolejną.
Tagi działają równolegle do folderów. Możesz tagować zarówno pliki, jak i foldery, a potem filtrować po nich z poziomu panelu HappyScribe, żeby przyspieszyć pracę. Jeśli plików jest za dużo, po prostu poproś Claude, żeby utworzył foldery i poprzenosił transkrypcje za ciebie.
Warto tu wspomnieć, że uprawnienia do folderów w HappyScribe przenoszą się dalej. Foldery prywatne zostają prywatne, a podfoldery dziedziczą ustawienia folderu nadrzędnego, więc Claude nie sięgnie po dane, których mu nie udostępnisz.
Krok 3: Podłącz repozytorium do Claude
Podłączenie zajmuje kilka minut i robi się je tylko raz.
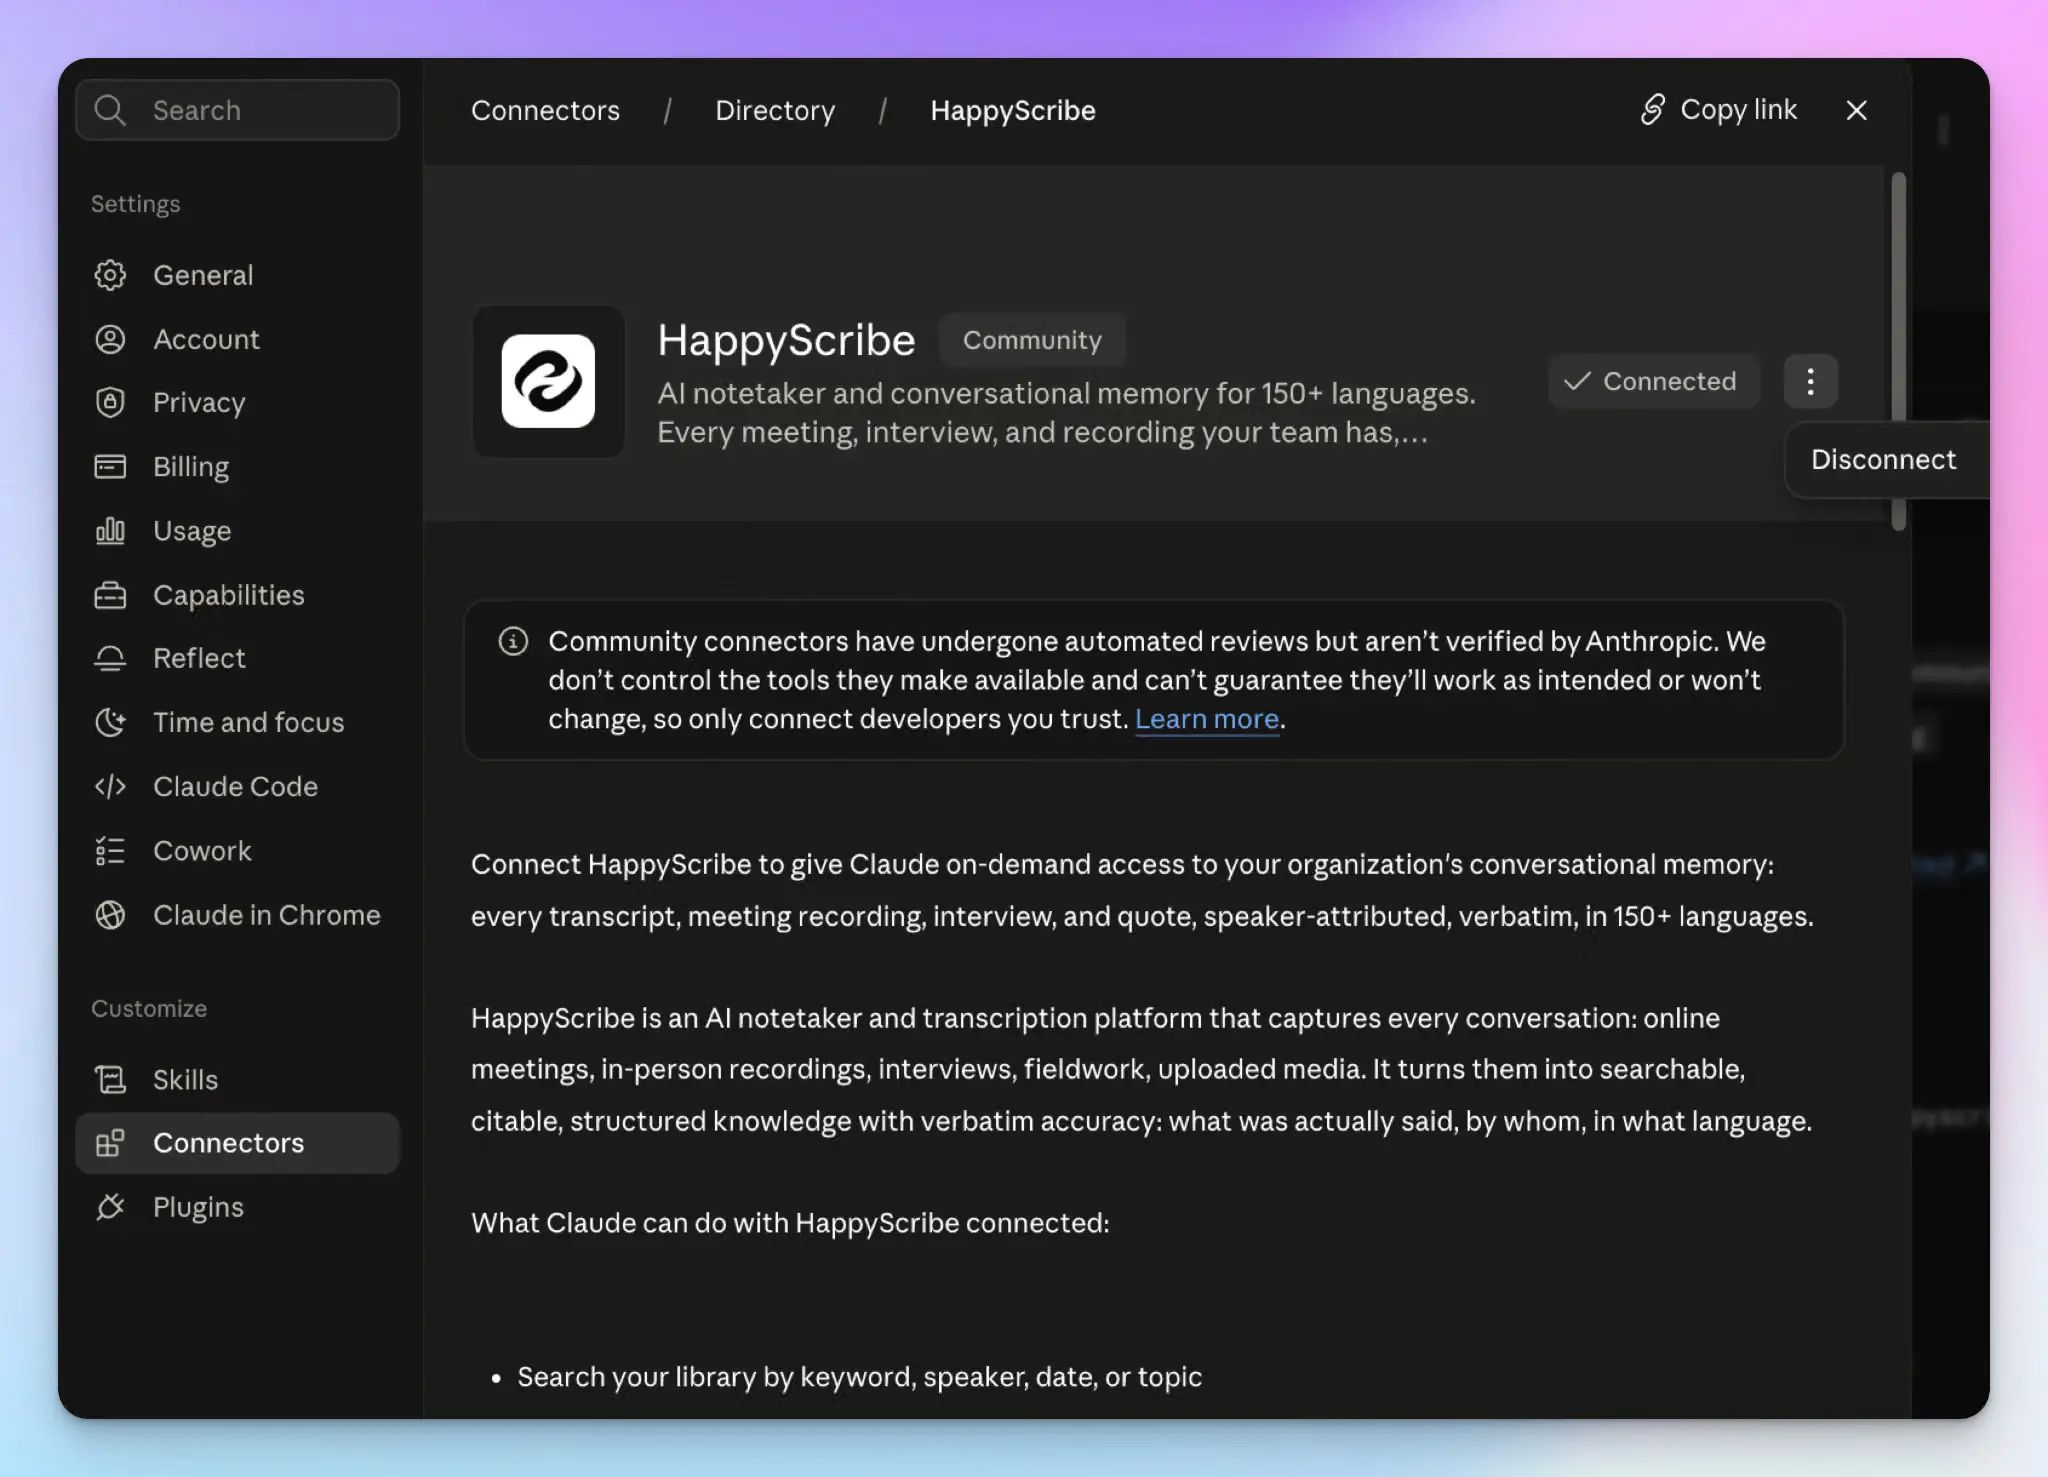
Od strony Claude:
- Rozwiń lewy pasek boczny i kliknij Customize > Connectors.
- Wyszukaj HappyScribe i kliknij ikonę + lubprzycisk Connect to Claude.
- Zaloguj się na swoje konto HappyScribe i autoryzuj dostęp.
Możesz też zacząć od strony HappyScribe. Kliknij Integrations w lewym pasku bocznym, znajdź kafelek Claude i kliknij Connect.
Aplikacja Claude Desktop i Claude Code korzystają z tego samego serwera MCP HappyScribe, dodawanego przez ustawienia dla programistów albo jedną komendę w terminalu. Administratorzy enterprise mogą udostępnić konektor całej przestrzeni roboczej.
Po podłączeniu Claude sięga po twoje transkrypcje tylko wtedy, gdy go o to poprosisz. Nic nie jest kopiowane z wyprzedzeniem i żadne badanie nie opuszcza HappyScribe, dopóki nie zażąda tego prompt.
Posłuchaj, co mówią nasi użytkownicy korzystający z HappyScribe razem z Claude:
Używam HappyScribe do wszystkich swoich spotkań — nagrywam sesje, robię notatki, dostaję podsumowania i mam to wszystko połączone przez ich MCP z moim kontem Claude. Uwielbiam to, że transkrypcje w moim języku (bułgarskim) są dokładne i oszczędzają mi mnóstwo czasu.
Krok 4: Zadawaj pytania całemu repozytorium
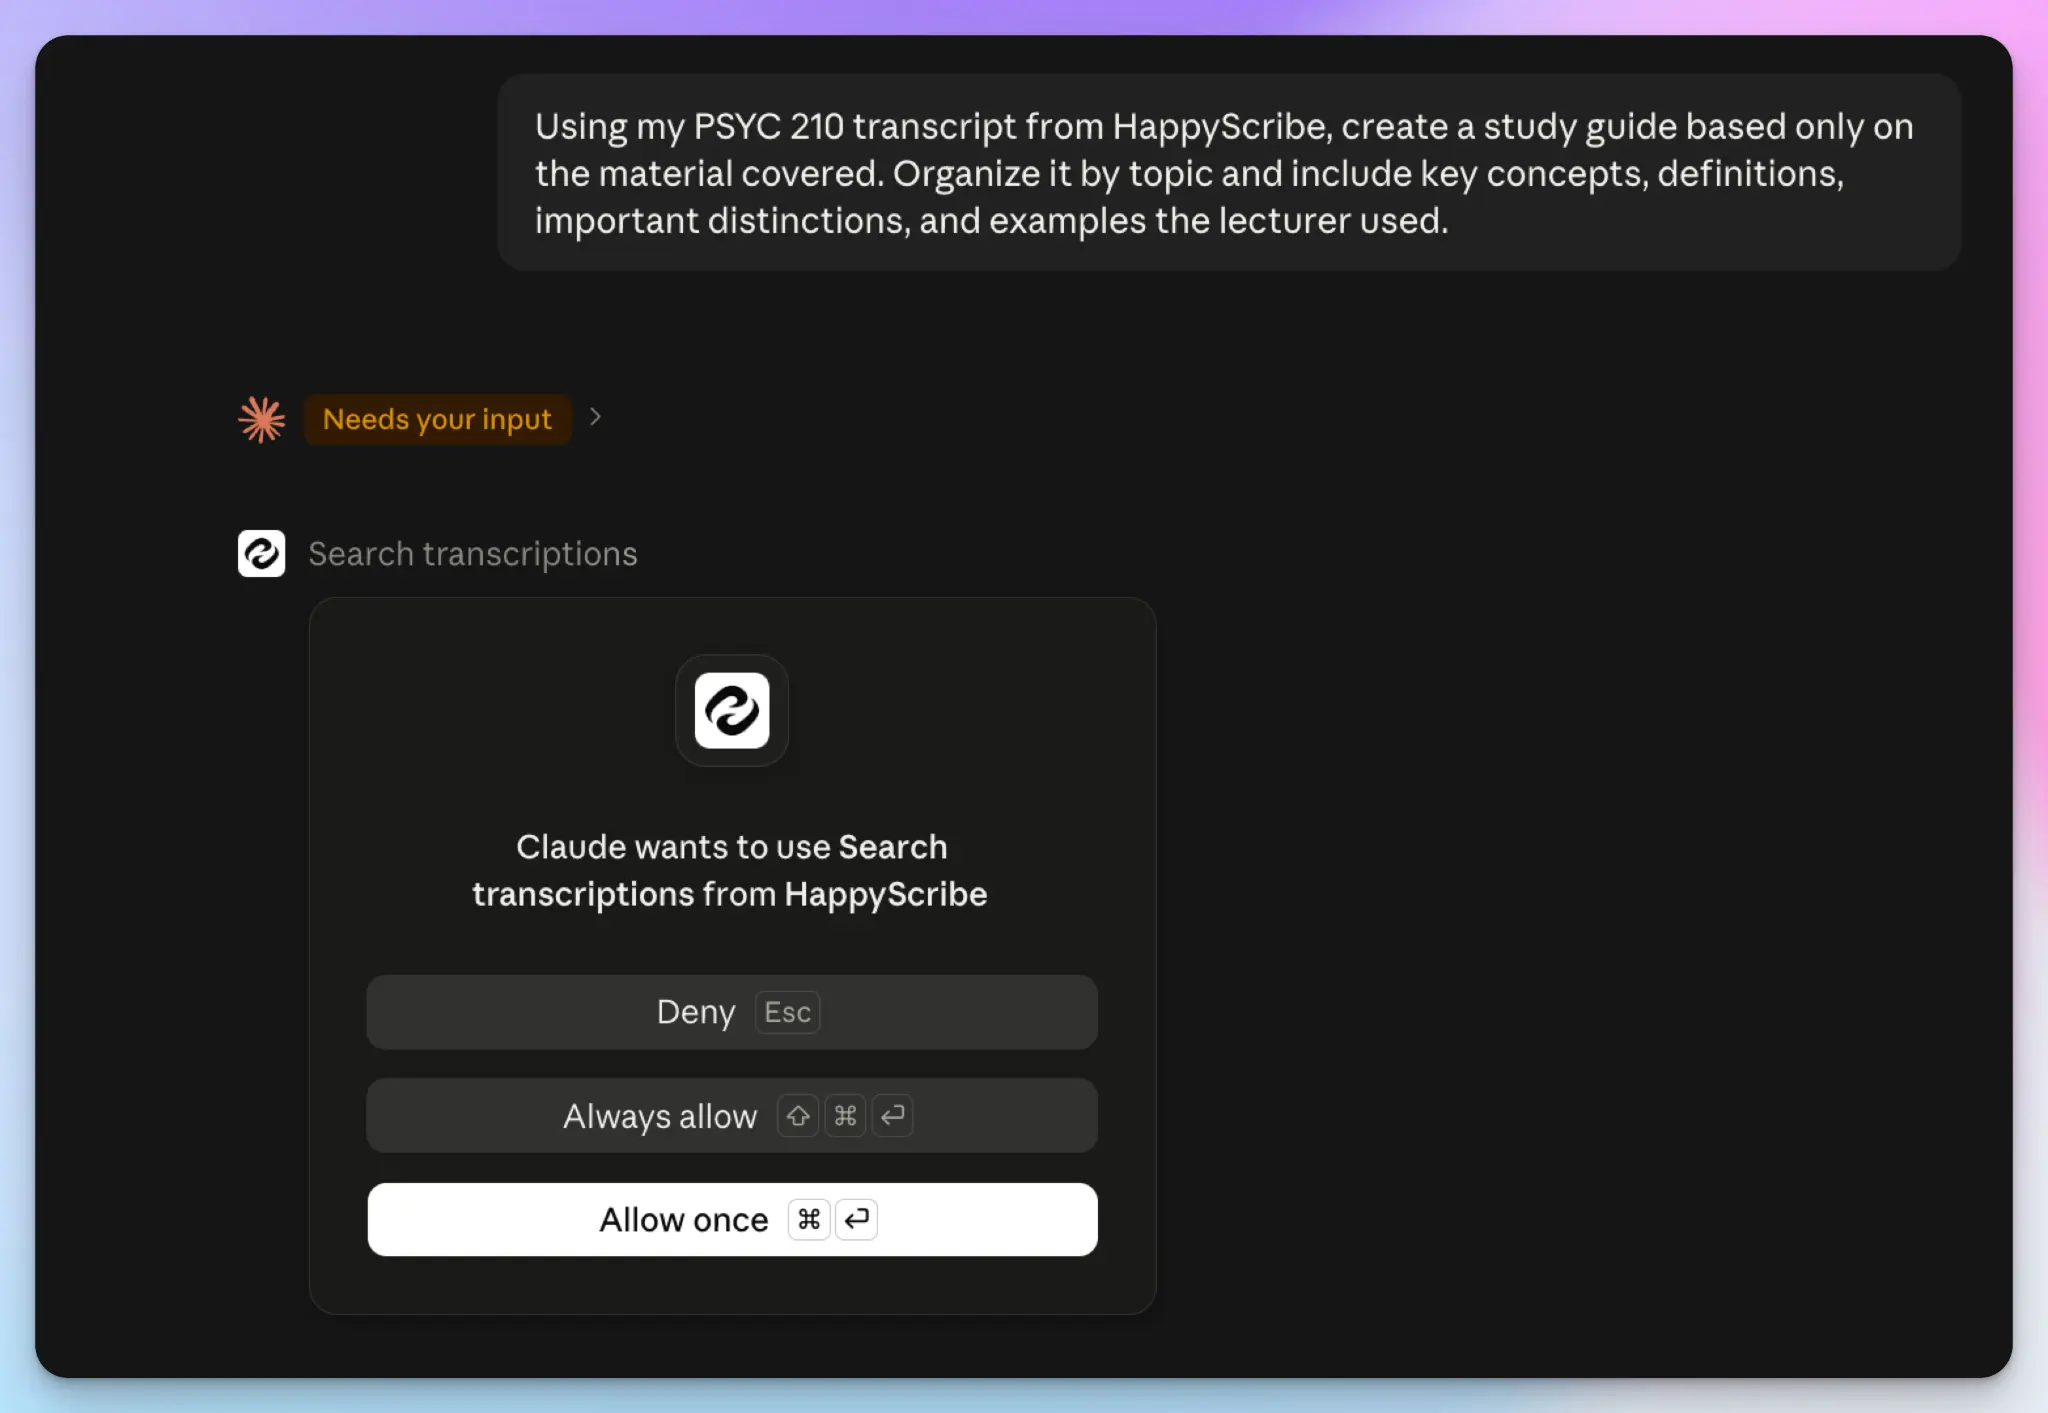
Tu zaczynasz naprawdę korzystać ze swojego repozytorium. Zamiast przypominać sobie, w którym wywiadzie padł konkretny komentarz, po prostu o niego pytasz. Oto pełen zakres możliwości, jakie HappyScribe daje Claude:
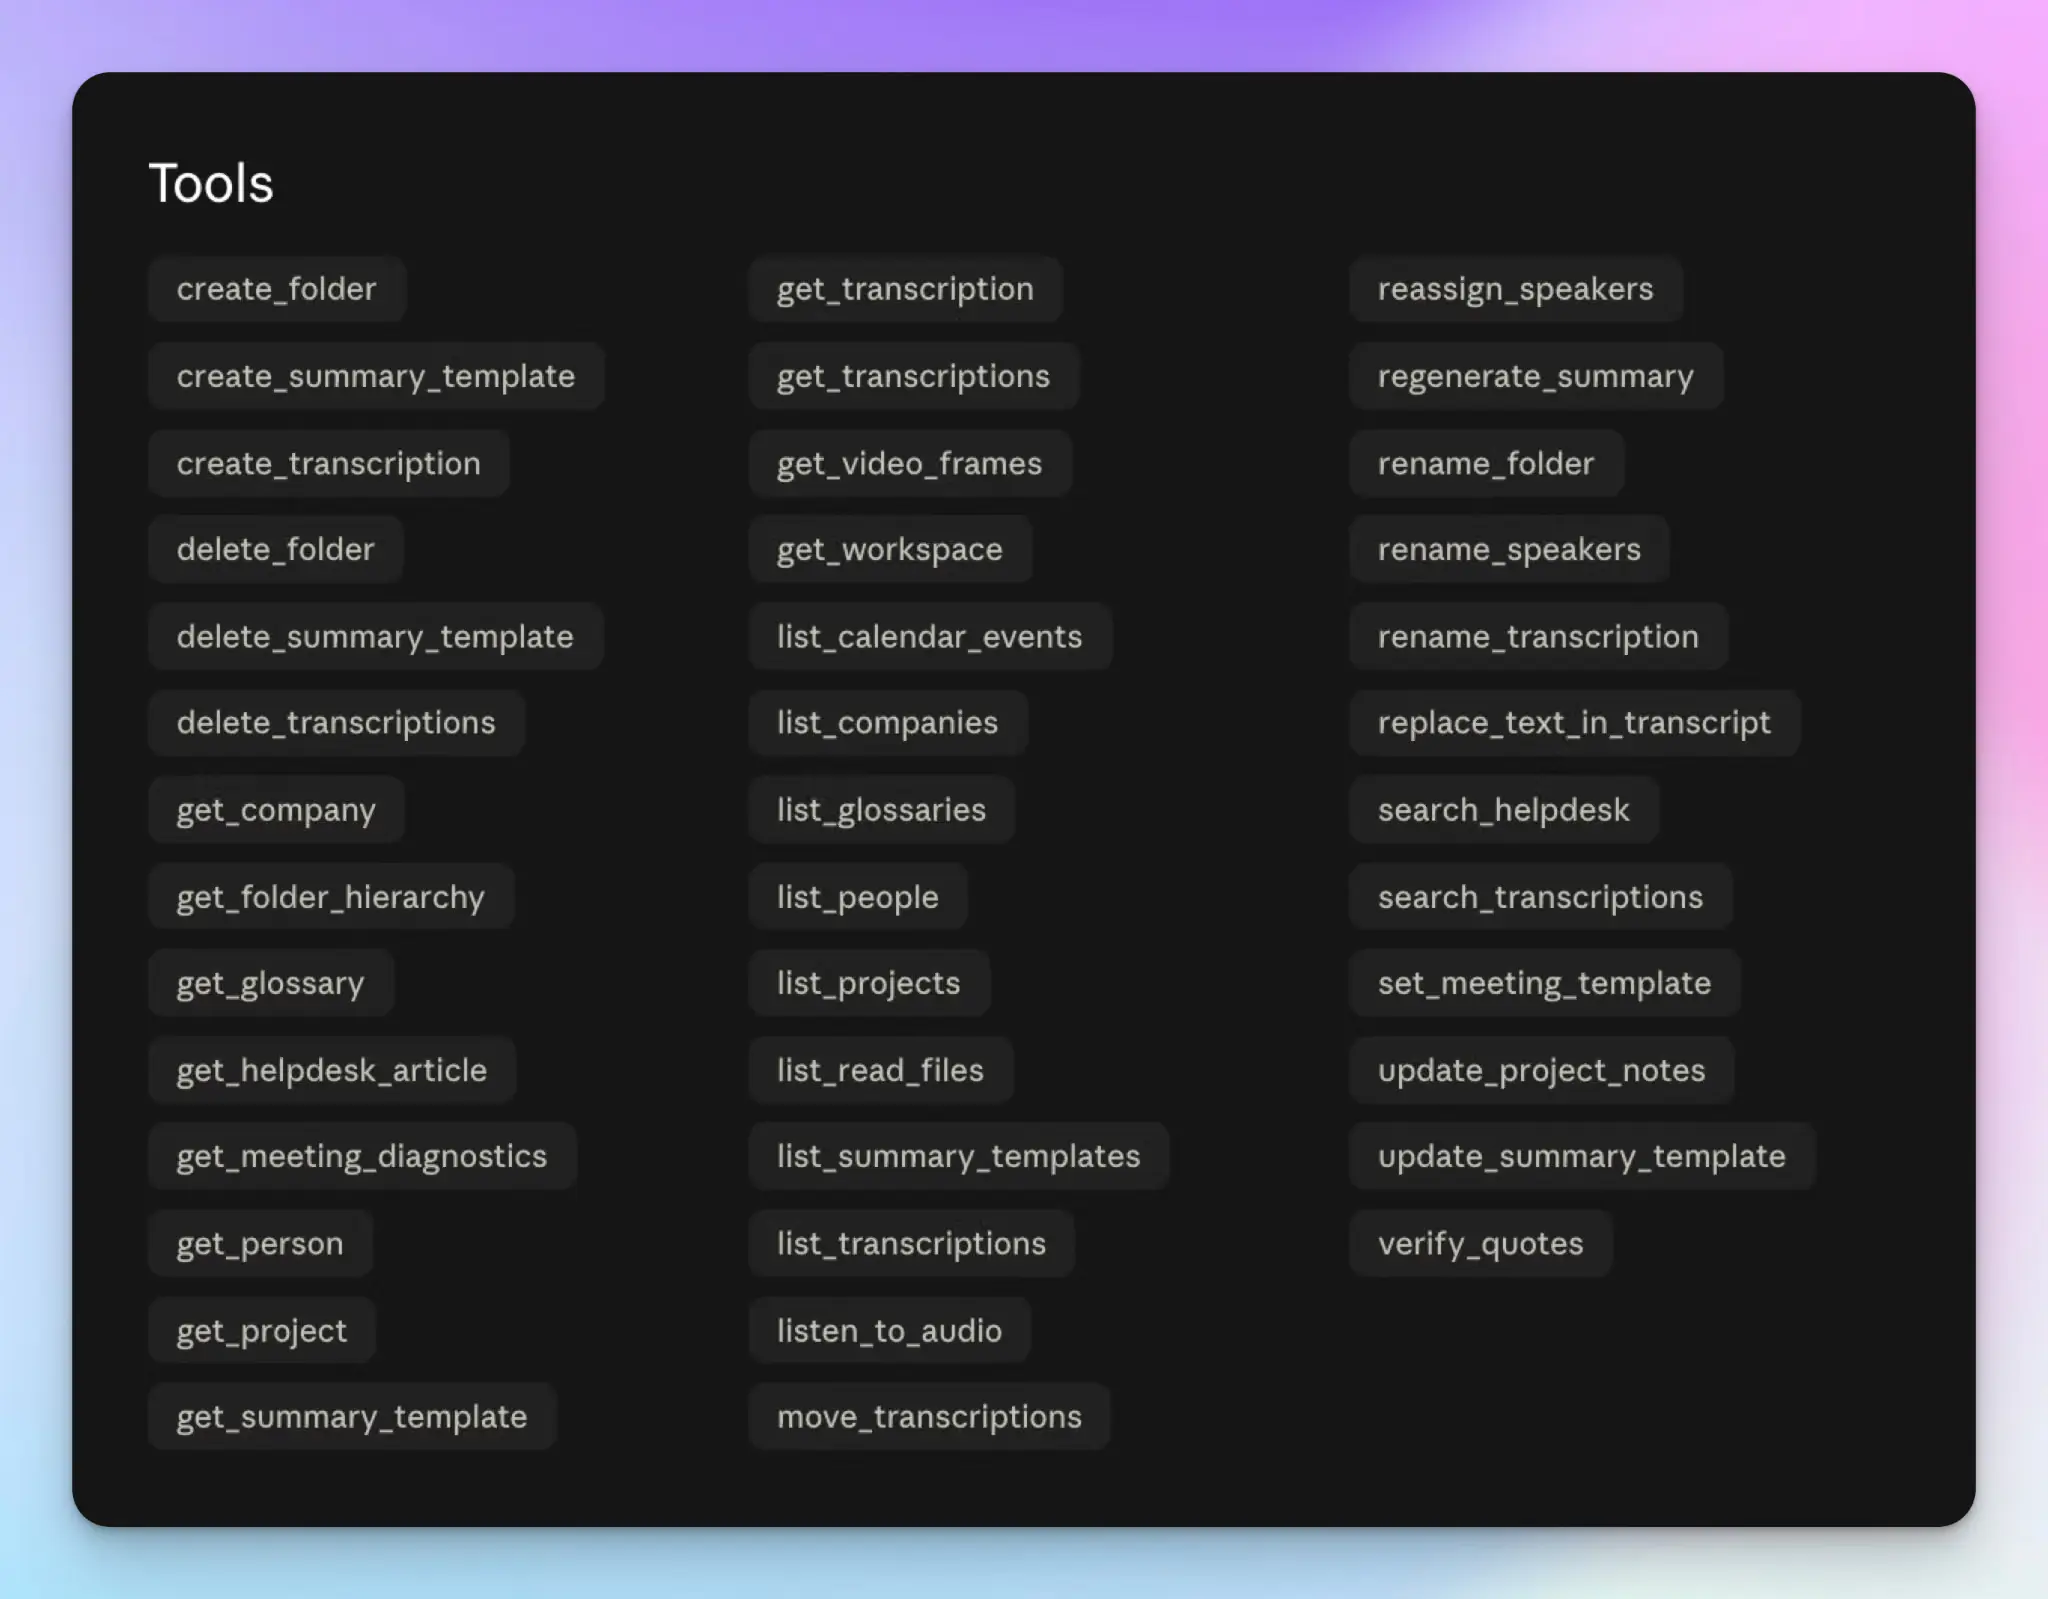
Zacznij od wyszukiwania. Claude przeszukuje treść transkrypcji tak, jak przeszukujesz dokument, i filtruje po tym, kto był na spotkaniu i kiedy odbyła się rozmowa:
Znajdź wywiady, w których klienci opisywali trudności z konfiguracją swojej przestrzeni roboczej.
Które rozmowy z zeszłego kwartału poruszały obawy o ceny?
Pokaż mi wszystkie sesje, w których prowadzącą była Joy M.
Potem wyjdź poza samo szukanie plików. To samo połączenie pozwala Claude czytać cały folder i odpowiadać na pytania, na które żadna pojedyncza transkrypcja nie odpowie:
W wywiadach o onboardingu w tym folderze — jakie problemy pojawiły się w więcej niż jednej sesji?
Jakie powody odejścia podawali klienci, którzy zrezygnowali?
Jakie obiekcje pojawiały się najczęściej w naszych rozmowach discovery?
Zespoły produktowe i te pracujące z klientami spędzały nad drugą grupą pytań całe tygodnie. Trzeba było kodować transkrypcje, tagować cytaty według wątków i liczyć, jak często coś się powtarzało — wszystko ręcznie. Claude robi pierwsze przejście w kilka minut.
Przy okazji łatwo też wyciągniesz dane. Poproś o zestawienie próśb o funkcje w formie tabeli z uczestnikiem i datą sesji, a masz coś, co możesz od razu przekazać przełożonemu.
Użytkownicy doceniają wygodę pracy z HappyScribe + Claude:
Natywna integracja z Claude przez MCP to powód, dla którego wdrożyliśmy HappyScribe — i weszło nam to w codzienny nawyk szybciej, niż się spodziewałem. Pytam Claude głosowo, przez słuchawki podczas spaceru, do czego zobowiązałem się partnerowi na naszym ostatnim spotkaniu — bez pisania, bez grzebania w notatkach.
Krok 5: Buduj wątki, nie odrywając ich od dowodów
W tym samym badaniu User Interviews, o którym wspominałem wcześniej, 91% ankietowanych przyznało, że martwi ich dokładność wyników i halucynacje. Badacze mają prawo obawiać się wątku, który brzmi wiarygodnie, ale nie ma pokrycia w niczym.
Rozwiązanie: nigdy nie puszczaj wniosku w obieg bez dowodu. Proś o jedno i drugie w tym samym promptcie:
Zidentyfikuj powtarzające się problemy z onboardingiem w tych wywiadach. Przy każdym wątku dodaj potwierdzające cytaty ze znacznikami czasu i wskaż, którzy uczestnicy to powiedzieli.
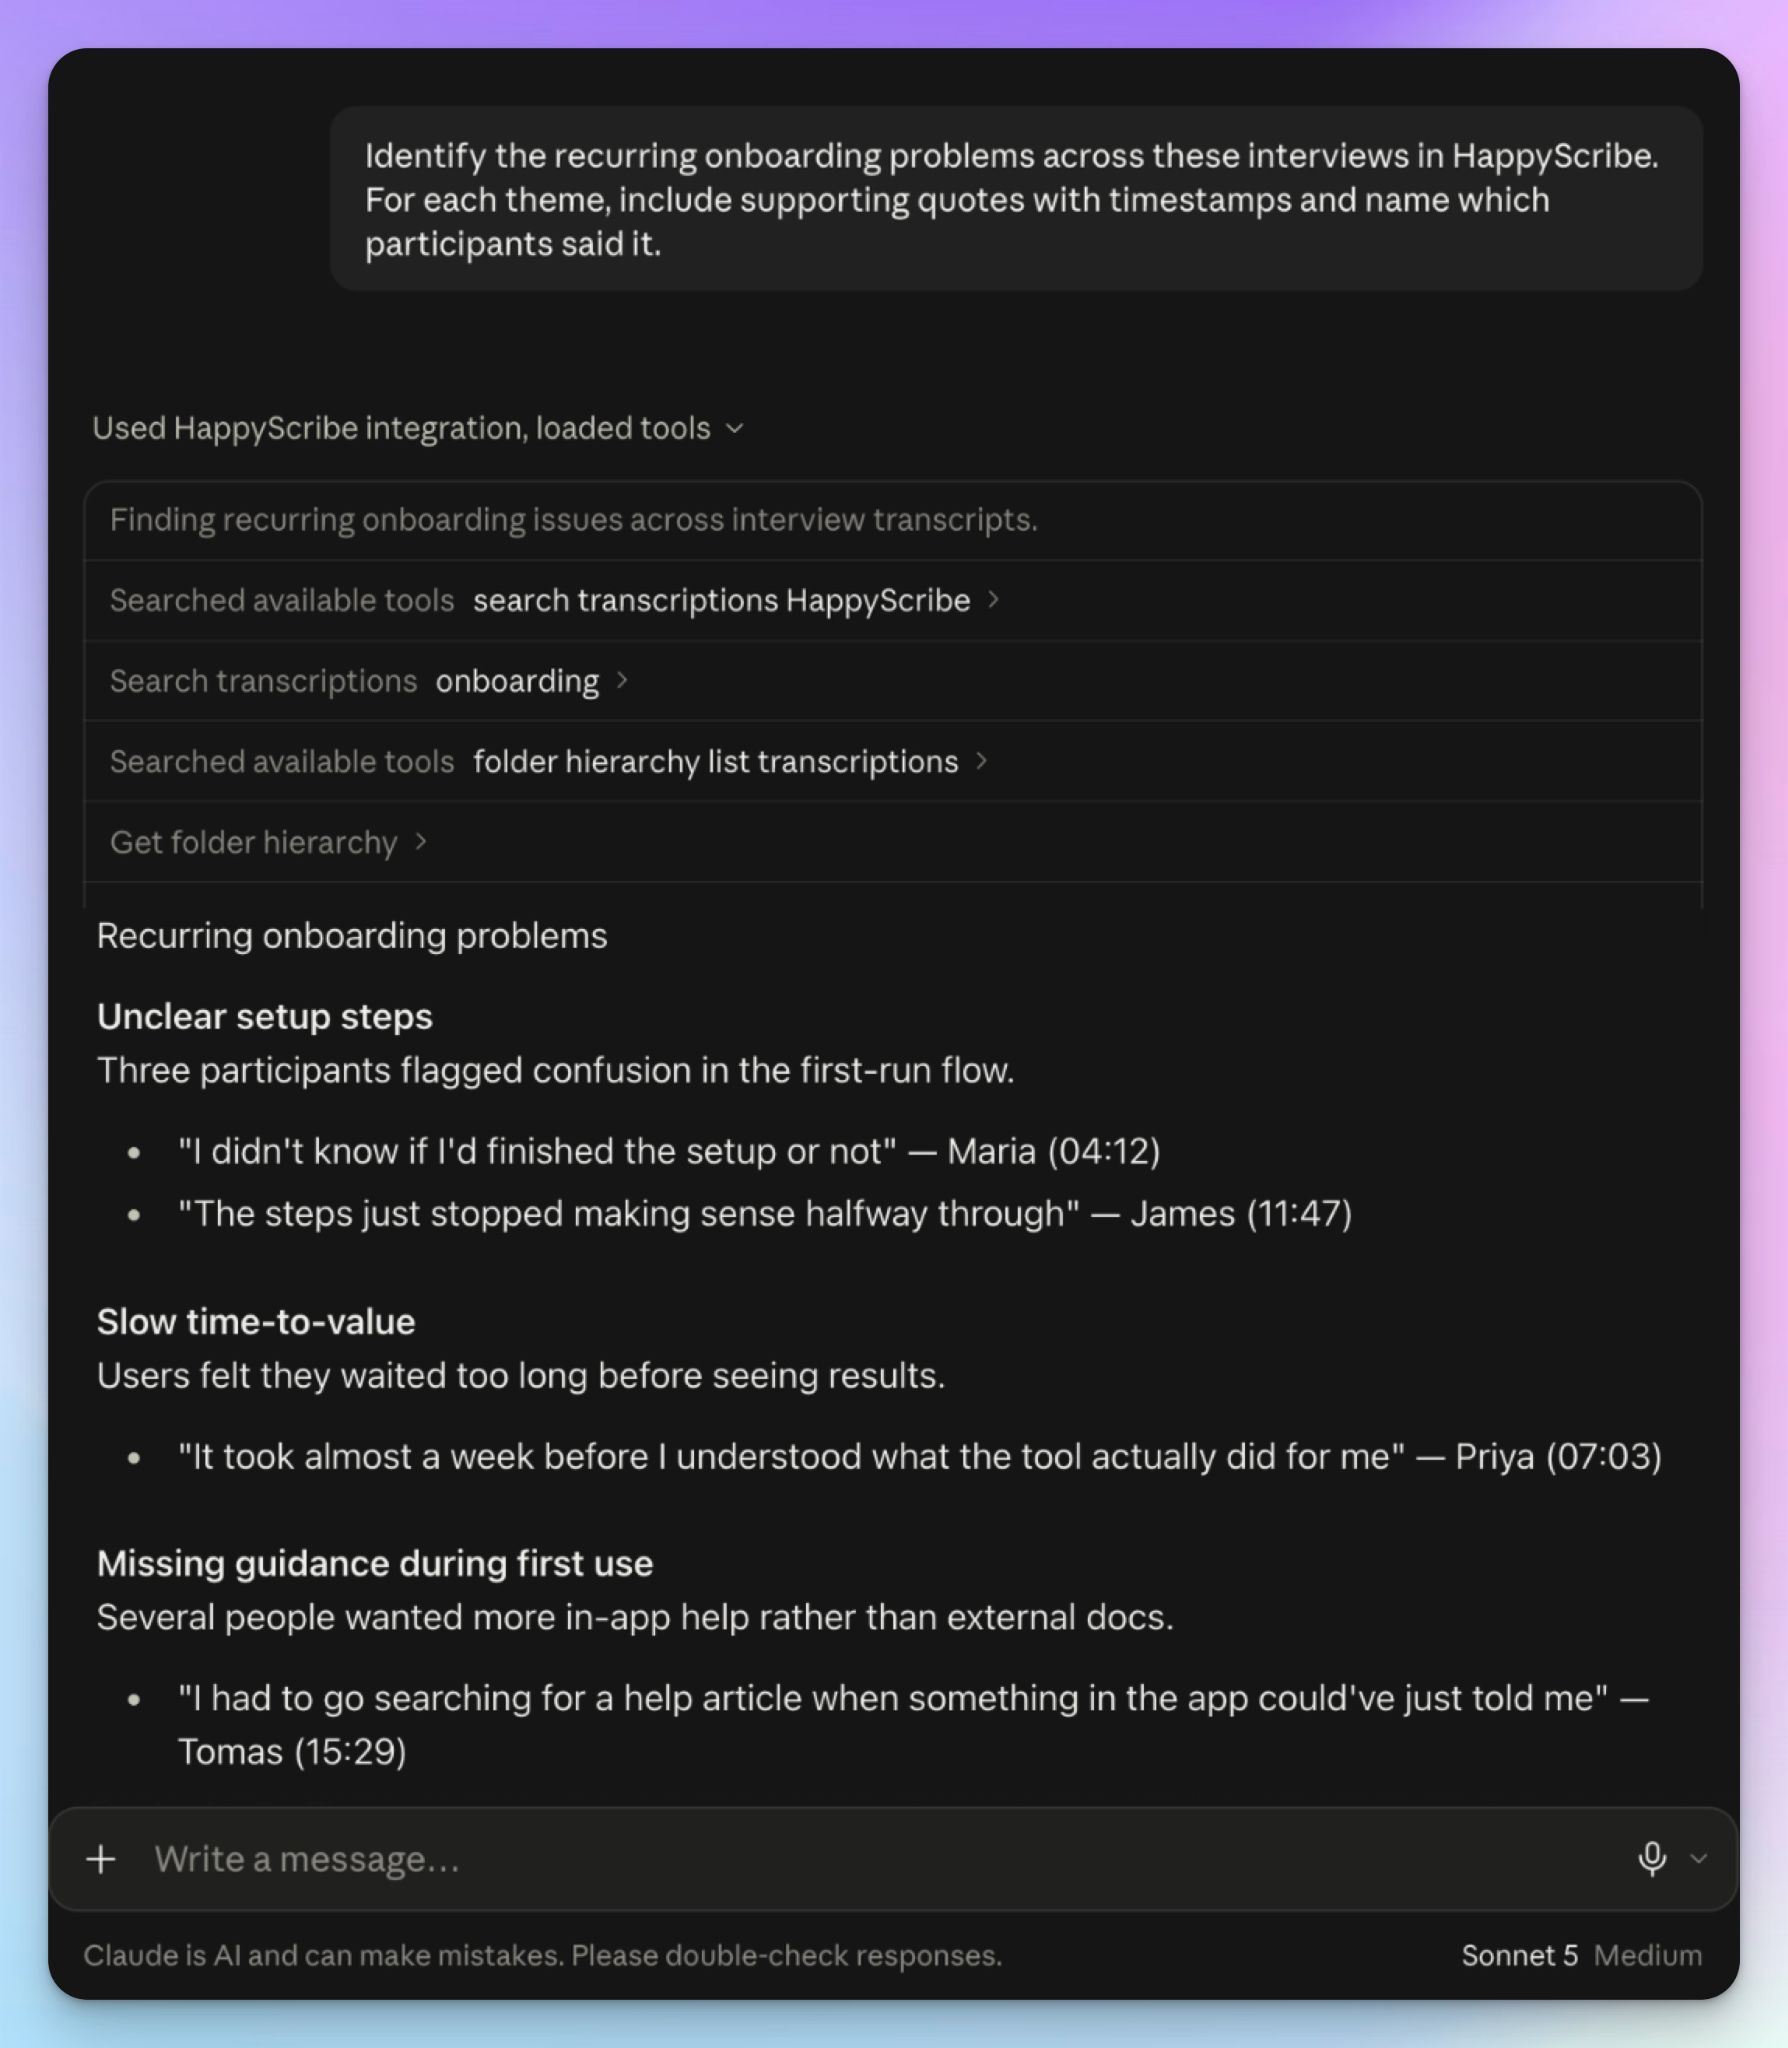
Claude zwraca dokładne cytaty ze znacznikami czasu i linki prowadzące z powrotem do edytora HappyScribe, więc każde twierdzenie sprawdzisz jednym kliknięciem. Usłyszysz ton, wahanie i pytanie, które je wywołało.
Potem uruchom pętlę: zidentyfikuj wątek > poproś o dowód > otwórz cytat > potwierdź, że znaczy to, co mówi wątek.
Ostatni krok należy do ciebie. Claude grupuje to, co brzmi podobnie, a ty decydujesz, czy dwóch klientów mówiących o „zagmatwanej konfiguracji” opisuje ten sam problem, czy dwa różne.
Krok 6: Zamień zweryfikowane wnioski w gotowe materiały
Dopiero teraz ma sens proszenie Claude o napisanie czegokolwiek. Trzymaj się właściwej kolejności: pytanie > dowód > synteza > twoja weryfikacja > gotowy materiał. Jeśli przeskoczysz od razu do gotowego materiału, dostaniesz dopracowaną prozę zbudowaną na niesprawdzonych grupowaniach.
Kiedy wnioski się bronią, to samo połączenie wygeneruje:
- Raporty z badań z już podpiętymi cytatami i znacznikami czasu
- Podsumowania głosu klienta dla zespołów, które nie przeczytają pełnego raportu
- Briefy o szansach produktowych oparte na tym, co klienci faktycznie powiedzieli
- Aktualizacje dla interesariuszy odpowiadające na pytanie, które ktoś zadał na spotkaniu
- Zbiory cytatów do komunikacji, stron produktowych albo prezentacji sprzedażowej
Poproś o taki format, jakiego potrzebujesz. Skoro dowody są już przypięte do źródła, na takim materiale można opierać decyzje.
Pytania, które warto zadać swojemu repozytorium
Powyższe kroki sprawią, że repozytorium zacznie działać. Oto kilka pytań, które pomogą ci wycisnąć z niego najwięcej:
Zweryfikuj hipotezę na podstawie dowodów
Zespoły bez przerwy spierają się o założenia. Repozytorium pozwala sprawdzić jedno z nich, zanim dyskusja pójdzie dalej.
Uważamy, że złożoność konfiguracji to nasza największa bariera aktywacji. Co w tych wywiadach to potwierdza, a co temu przeczy?
Porównaj grupy klientów
Jeśli ciągle będziesz zaczynać od zagregowanych wątków, zbudujesz uśrednionego klienta, który nie przypomina twojej bazy użytkowników.
Czym opis tego problemu u klientów enterprise różni się od opisu u klientów z segmentu SMB?
To zadziała tylko wtedy, gdy rozróżnienie istnieje w twoich folderach albo w tym, co powiedzieli uczestnicy — segmentuj więc wcześnie, jeśli wiesz, że będziesz tego później potrzebować.
Znajdź to, co przeczy dominującemu wątkowi
Konsensus łatwo znaleźć, ale potrafi też mylić. Ze sprzecznymi dowodami podejmiesz mądrzejsze decyzje produktowe.
Większość uczestników mówiła, że onboarding był trudny. Znajdź wywiady, które temu przeczą, i wyjaśnij, co odróżniało tych klientów.
Śledź, jak feedback zmieniał się w czasie
Porównaj skargi na onboarding z Q1 z naszymi najnowszymi wywiadami. Co ucichło, a co jest nowe?
To właśnie zysk z zachowywania źródłowych rozmów zamiast traktowania każdego badania jako jednorazowej akcji. Mówi ci też, czy poprawka wdrożona w poprzedniej rundzie faktycznie zadziałała.
Prześledź jednego klienta we wszystkich rozmowach
HappyScribe buduje graf wiedzy o osobach i firmach wspominanych w twoich transkrypcjach, więc historię klienta da się odtworzyć z wielu osobnych sesji.
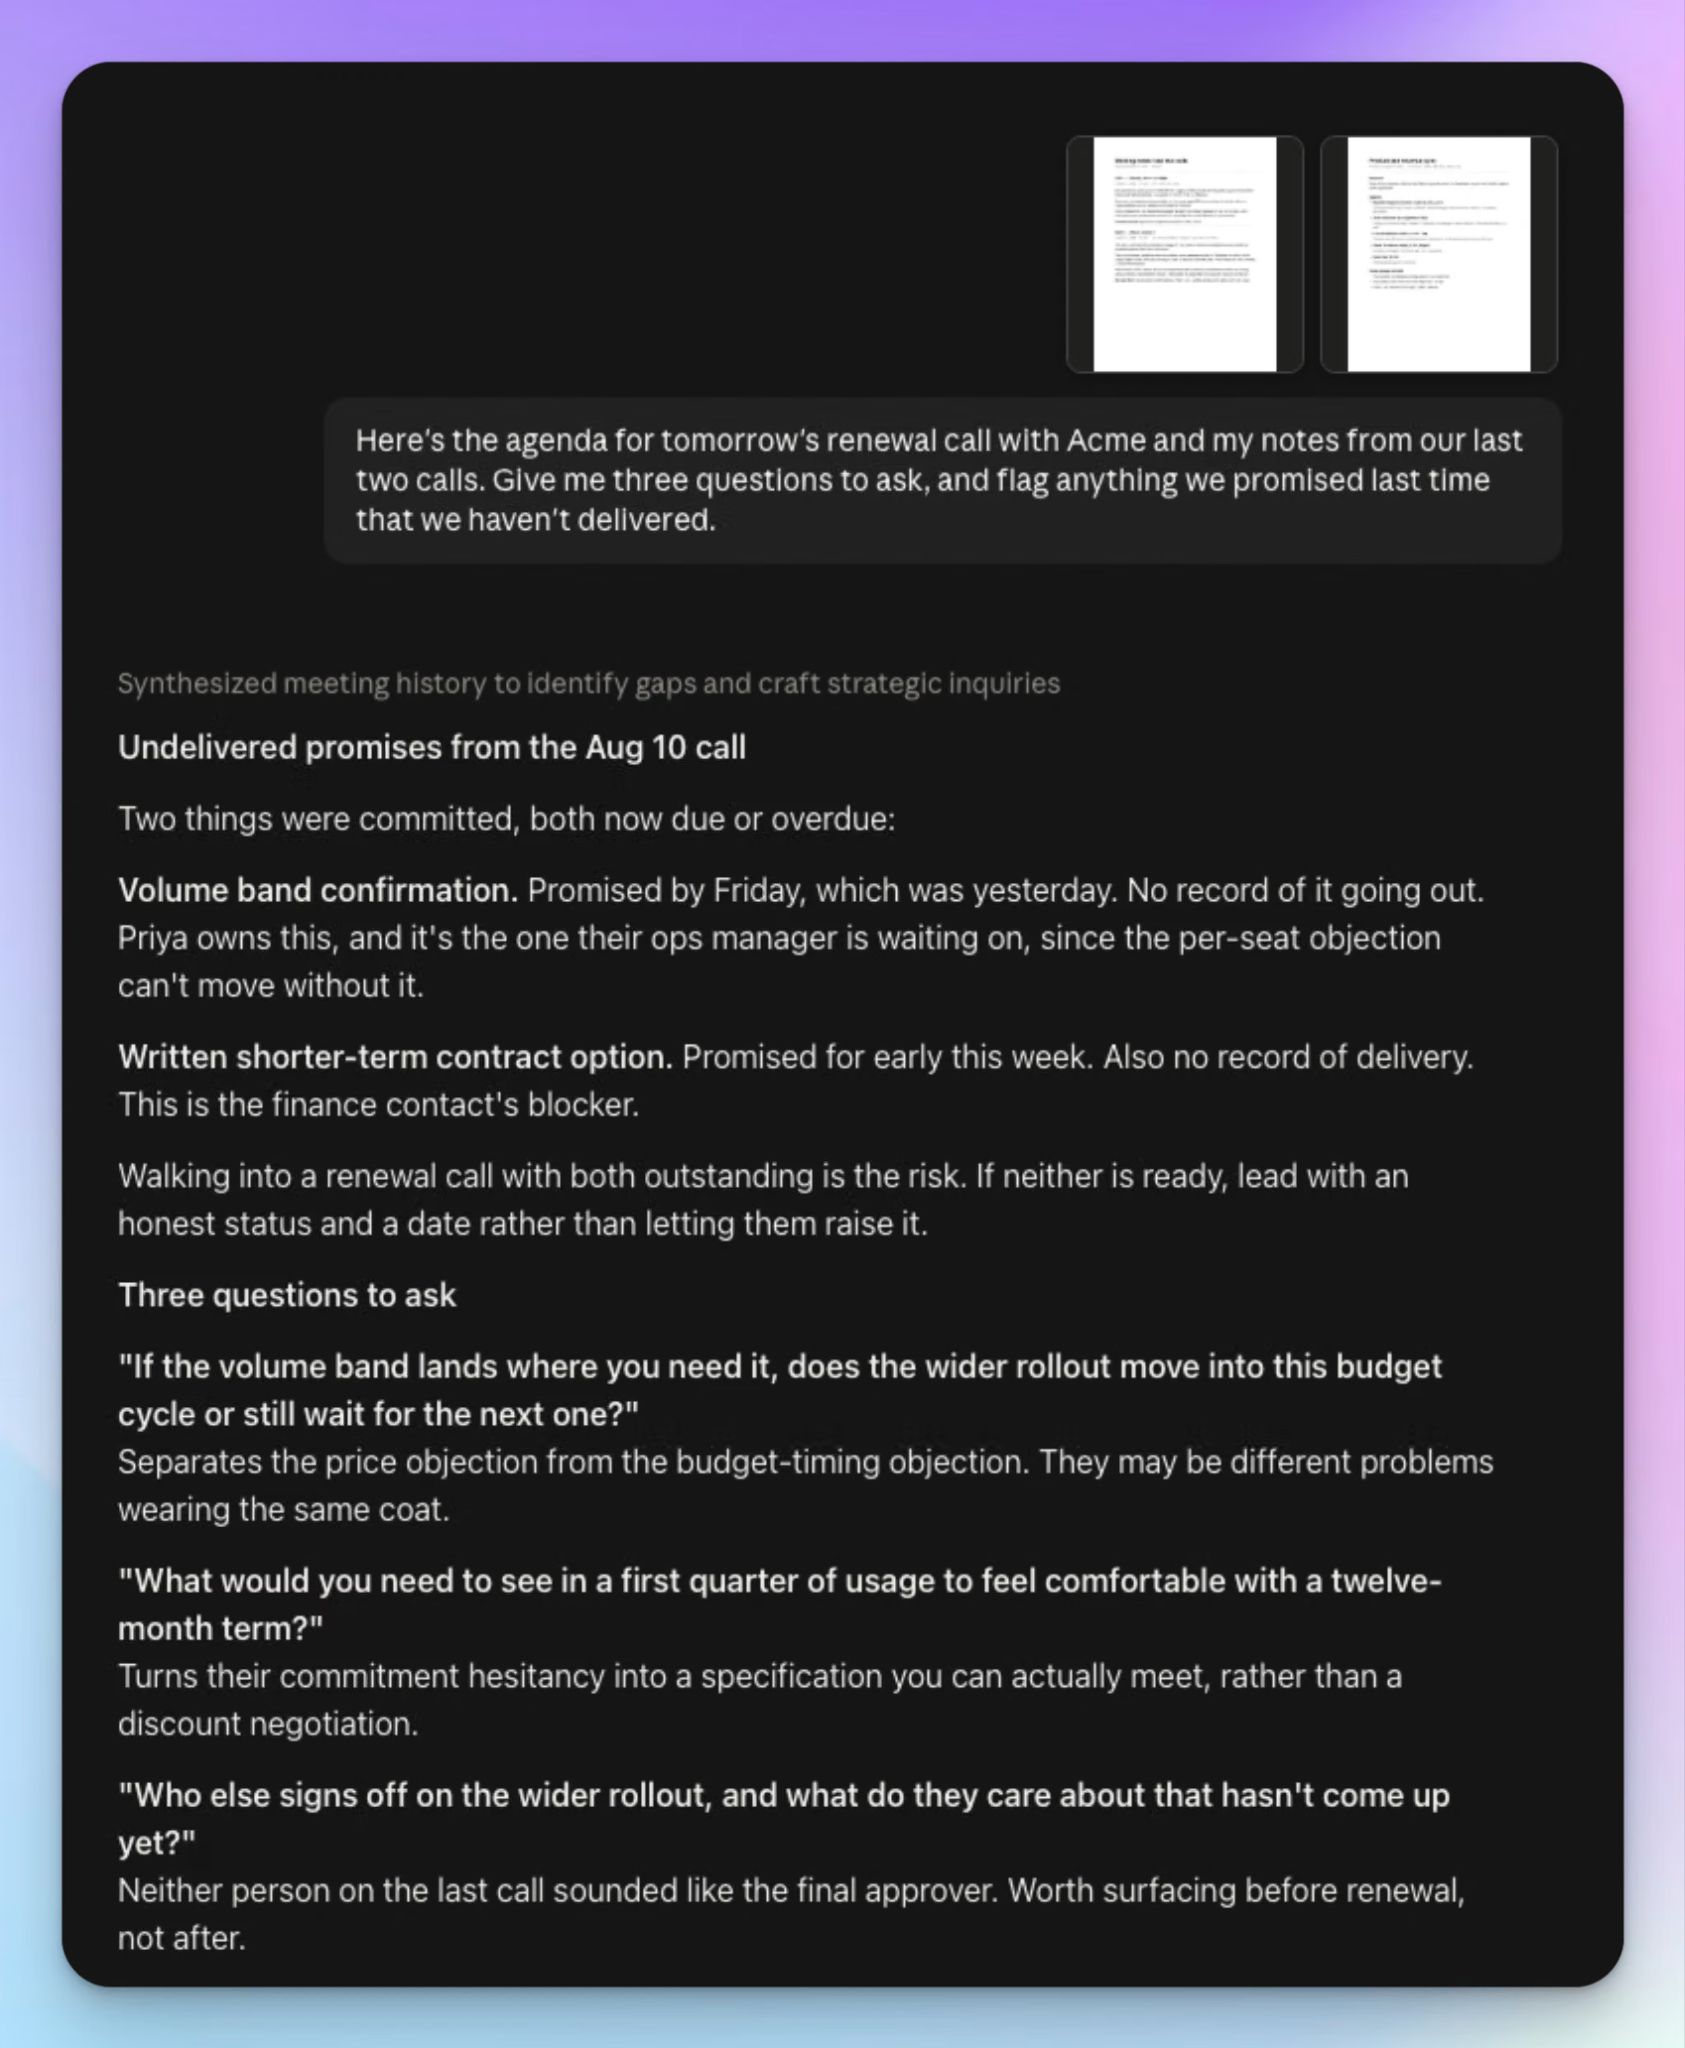
Co Acme mówiło o wdrożeniu we wszystkich naszych rozmowach i jak zmieniały się ich priorytety?
Przydatne przy odnowieniach i QBR-ach — choć to sposób na poruszanie się po własnych materiałach badawczych, a nie CRM.
Jak utrzymać wiarygodność repozytorium
Skoro repozytorium gromadzi rozmowy z klientami w jednym miejscu, trzeba uważniej podejść do tego, jak się z nimi obchodzisz.
Zbieraj zgodę podczas sesji, nie po fakcie. Powiedz uczestnikom, że rozmowa jest nagrywana i transkrybowana, i powiedz wprost, jeśli do jej analizy zostanie użyty asystent AI.
Pilnuj tego, co siedzi w transkrypcjach. Jakościowe wywiady badawcze zbierają nazwiska, nazwy pracodawców, dane kont i od czasu do czasu coś, czego uczestnik nie chciał zdradzić. Edytor HappyScribe pozwala to wyczyścić, zanim plik trafi do przeszukiwalnego repozytorium, a zanonimizowane transkrypcje bezpieczniej udostępnisz szerszemu gronu.
HappyScribe zapewnia bezpieczeństwo klasy enterprise: zgodność z RODO i SOC 2 Type II oraz hosting w UE — dlatego korzystają z niego zespoły prawne, akademickie i sprzedażowe przy pracy, której nie da się trzymać na zwykłym dysku.
Gdy to wszystko masz, zajmij się dostępami. Nie każdy, kto korzysta z wniosków, musi mieć dostęp do surowych sesji — uprawnienia do folderów są sposobem na wyznaczenie tej granicy. Administratorzy enterprise mogą to ustawić na poziomie całej przestrzeni roboczej.
Repozytorium badań klientów jest tym cenniejsze, im bardziej rośnie
Każdy dodany wywiad ułatwia rozstrzygnięcie kolejnego pytania, a żadna z tych prac nie wymaga odbudowywania kontekstu, gdy pojawia się nowe. Z Claude i HappyScribe badania rynku i produktu stają się po prostu łatwiejsze w codziennej pracy.
FAQ: budowanie repozytorium badań klientów z Claude
Czy Claude może analizować wiele transkrypcji wywiadów naraz?
Tak, ale nie metodą kopiuj-wklej. Wklejanie sprawdza się przy kilku wywiadach i powyżej tego progu przestaje działać — dlatego przy dużych repozytoriach badawczych Claude potrzebuje integracji MCP. Gdy HappyScribe jest podłączony, wskazujesz Claude folder, a on przeszukuje każdą transkrypcję w środku. Wyciąganie danych też staje się prostsze: poproś o tabelę z najczęściej zgłaszanymi problemami klientów, z uczestnikiem i datą sesji w każdym wierszu.
Czy potrzebuję Claude Code, żeby zbudować repozytorium badań klientów?
Nie. Większość badaczy nigdy go nie potrzebuje. Konektor sam obsługuje wyszukiwanie i syntezę. Claude Code przydaje się wtedy, gdy chcesz powtarzalny proces zamiast jednorazowej odpowiedzi — i nie musisz być programistą, żeby z niego korzystać. Dzięki vibe codingowi opisujesz zwykłym językiem, czego chcesz, a Claude napisze skrypt. Potem samodzielnie wykonuje wieloetapowe zadania na twoim komputerze i może zwrócić ustrukturyzowane pliki CSV z oceną pewności dla każdego wyciągniętego wniosku. To daje największą dźwignię: zakoduj ekstrakcję raz i uruchom ją ponownie na kolejnej rundzie wywiadów.
Czym różni się Claude Projects od konektora HappyScribe?
Projects dają ci trwały kontekst w obrębie jednego projektu. Pliki wgrywasz raz, a instrukcje projektu przenoszą założenia badania i kryteria włączenia do każdej nowej rozmowy, więc przestajesz tłumaczyć tło od nowa. Nadal jednak przerzucasz pliki — czy to z pulpitu, czy z Google Drive — a pojedyncza rozmowa pomieści tylko tyle. Konektor eliminuje ten krok, sięgając po transkrypcje tam, gdzie już są.
Czy Claude Cowork pomoże w syntezie badań?
Tak. Cowork powstał z myślą o pracownikach wiedzy, którzy realizują wieloetapowe zadania, a nie pojedyncze pytania. Wskaż Cowork folder z badaniem, a wyciągnie wątki, zbierze potwierdzające cytaty i przerobi je na prezentacje albo pisemne omówienie za jednym razem. Do samej syntezy używaj Claude Opus — tam, gdzie rozumowanie na sprzecznych dowodach liczy się najbardziej.
Jak nie dopuścić do tego, żeby Claude wymyślał cytaty w analizie badań?
Proś o dowód w tym samym promptcie, w którym prosisz o wniosek. Żądaj potwierdzających cytatów ze znacznikami czasu przy każdym wątku, a potem otwórz jeden czy dwa i sprawdź, czy znaczą to, co mówi wątek. Działa to tak samo przy wywiadach z klientami, przeglądzie literatury czy wspólnym archiwum prowadzonym przez twoją grupę badawczą. Narzędzia AI grupują to, co brzmi podobnie — to ty decydujesz, czy to prawda. Ten fact-check zamienia wynik w wnioski, na których da się działać.

Biplab Mazumder
Biplab is a content marketer and writer who helps high-growth brands scale content visibility across AI search channels. His works have been published in HubSpot, Freshworks, Atlassian, SurferSEO, etc. When he's not planning content strategy, he's testing AI content workflows and use cases.