TL;DR ⏩
- Leg alles op één plek vast. Interviews, discovery calls en opzeggesprekken komen allemaal binnen in HappyScribe via de AI-notulist, de mobiele app, bestandsuploads of link-imports
- Orden per map. Sorteer transcripties op project, segment of productgebied, zodat je Claude op één verzameling bewijsmateriaal kunt richten
- Koppel de Claude-connector van HappyScribe. Stel vragen over alle mappen heen om patronen te vinden, klantgroepen te vergelijken en hypotheses te toetsen aan je interviews
- Houd het bewijs eraan vast. Claude geeft citaten met tijdcodes terug, zodat elk thema herleidbaar is naar de bron voordat het in een deliverable belandt
"Ik heb alle klantinteracties en bevindingen van maanden geleden direct bij de hand," zei nog nooit een onderzoeker.
Je weet dat die klantfeedback er ergens is. Maar de data van vorig kwartaal ordenen en binnen een minuut presenteren is een crime.
Bijna de helft van de onderzoekers (49%) vertelde User Interviews dat ze negatief zijn over de toekomst van UX-onderzoek, een sprong van 26 punten in één jaar. Tegelijkertijd gebruikt inmiddels 80% ergens in het onderzoekswerk AI.
Met zoveel verandering in de branche wil je geen bewijsmateriaal kwijtraken waar je al hard voor hebt gewerkt.
De oplossing: bouw je repository voor klantonderzoek in HappyScribe en zet Claude daar bovenop. Op papier een onwaarschijnlijk duo, maar voor onderzoekers en bureaus werkt het uitstekend.
Wat een repository voor klantonderzoek precies is
Een repository voor klantonderzoek is een centrale opslagplaats voor je klantbewijs die langer meegaat dan het project waaruit het voortkwam. Het is geen pitchdeck of een samenvatting die iemand tijdens een vergadering opschreef; het bevat de gesprekken zelf.
Wat teams een repository noemen, is meestal een map met onderzoeksrapporten, en een rapport is al een ingedikte versie van een subjectieve interpretatie. Het is gemaakt voor één specifiek project en werkt niet als één enkele bron van klantwaarheid.
Wat hoort er in een onderzoeksrepository:
- Klant- en gebruikersinterviews
- Usability-sessies
- Discovery calls en notulen van salesgesprekken
- Churn- en opzeggingsinterviews
- Adviesgesprekken met klanten
- Onboardinggesprekken waarin deelnemers iets bruikbaars zeiden
Transcriptie is wat dit allemaal mogelijk maakt. Als je audio en video nauwkeurig opneemt en omzet naar tekst, kun je in een interactieve transcriptie op trefwoorden zoeken, inclusief tijdcodes. Het bewijsmateriaal uit al die bronnen blijft binnen handbereik, maanden nadat het onderzoek is afgerond.
Waarom een map met transcripties én Claude alleen allebei tekortschieten
Je kunt nu al een vergadertranscriptie in Claude plakken en er een prima analyse uit halen. Voor één interview werkt dat goed, maar stel je voor dat je 20 interviews van drie maanden moet verwerken!
De handmatige workflow is bestand zoeken > uploaden > onderzoekscontext uitleggen > analyse draaien > volgende keer weer opnieuw. Claude Projects lost daar een deel van op.
Je uploadt de relevante bestanden één keer als projectkennis, en met aangepaste instructies neem je je onderzoeksopzet mee naar elke nieuwe chat. Elke chat begint met die context al geladen, zodat je niet steeds hetzelfde verhaal hoeft uit te leggen.
Wat Claude Projects niet oplost, is volume. Claude werkt prima met een handvol interviewtranscripties voordat het contextvenster vol zit, maar een repository is gebouwd om daar ver overheen te groeien.
Daar is het Model Context Protocol voor. Een MCP-koppeling verbindt je onderzoeksrepository rechtstreeks met Claude, zodat Claude bij de transcripties kan waar ze al staan.
Claude Connectors zijn op dat framework gebouwd, en ik help je die instellen.
Stap 1: Leg elk klantgesprek op één plek vast
Voordat Claude nuttig kan zijn, moeten de gesprekken ergens als tekst bestaan. HappyScribe regelt dat op vier manieren, afhankelijk van hoe jij onderzoek doet.
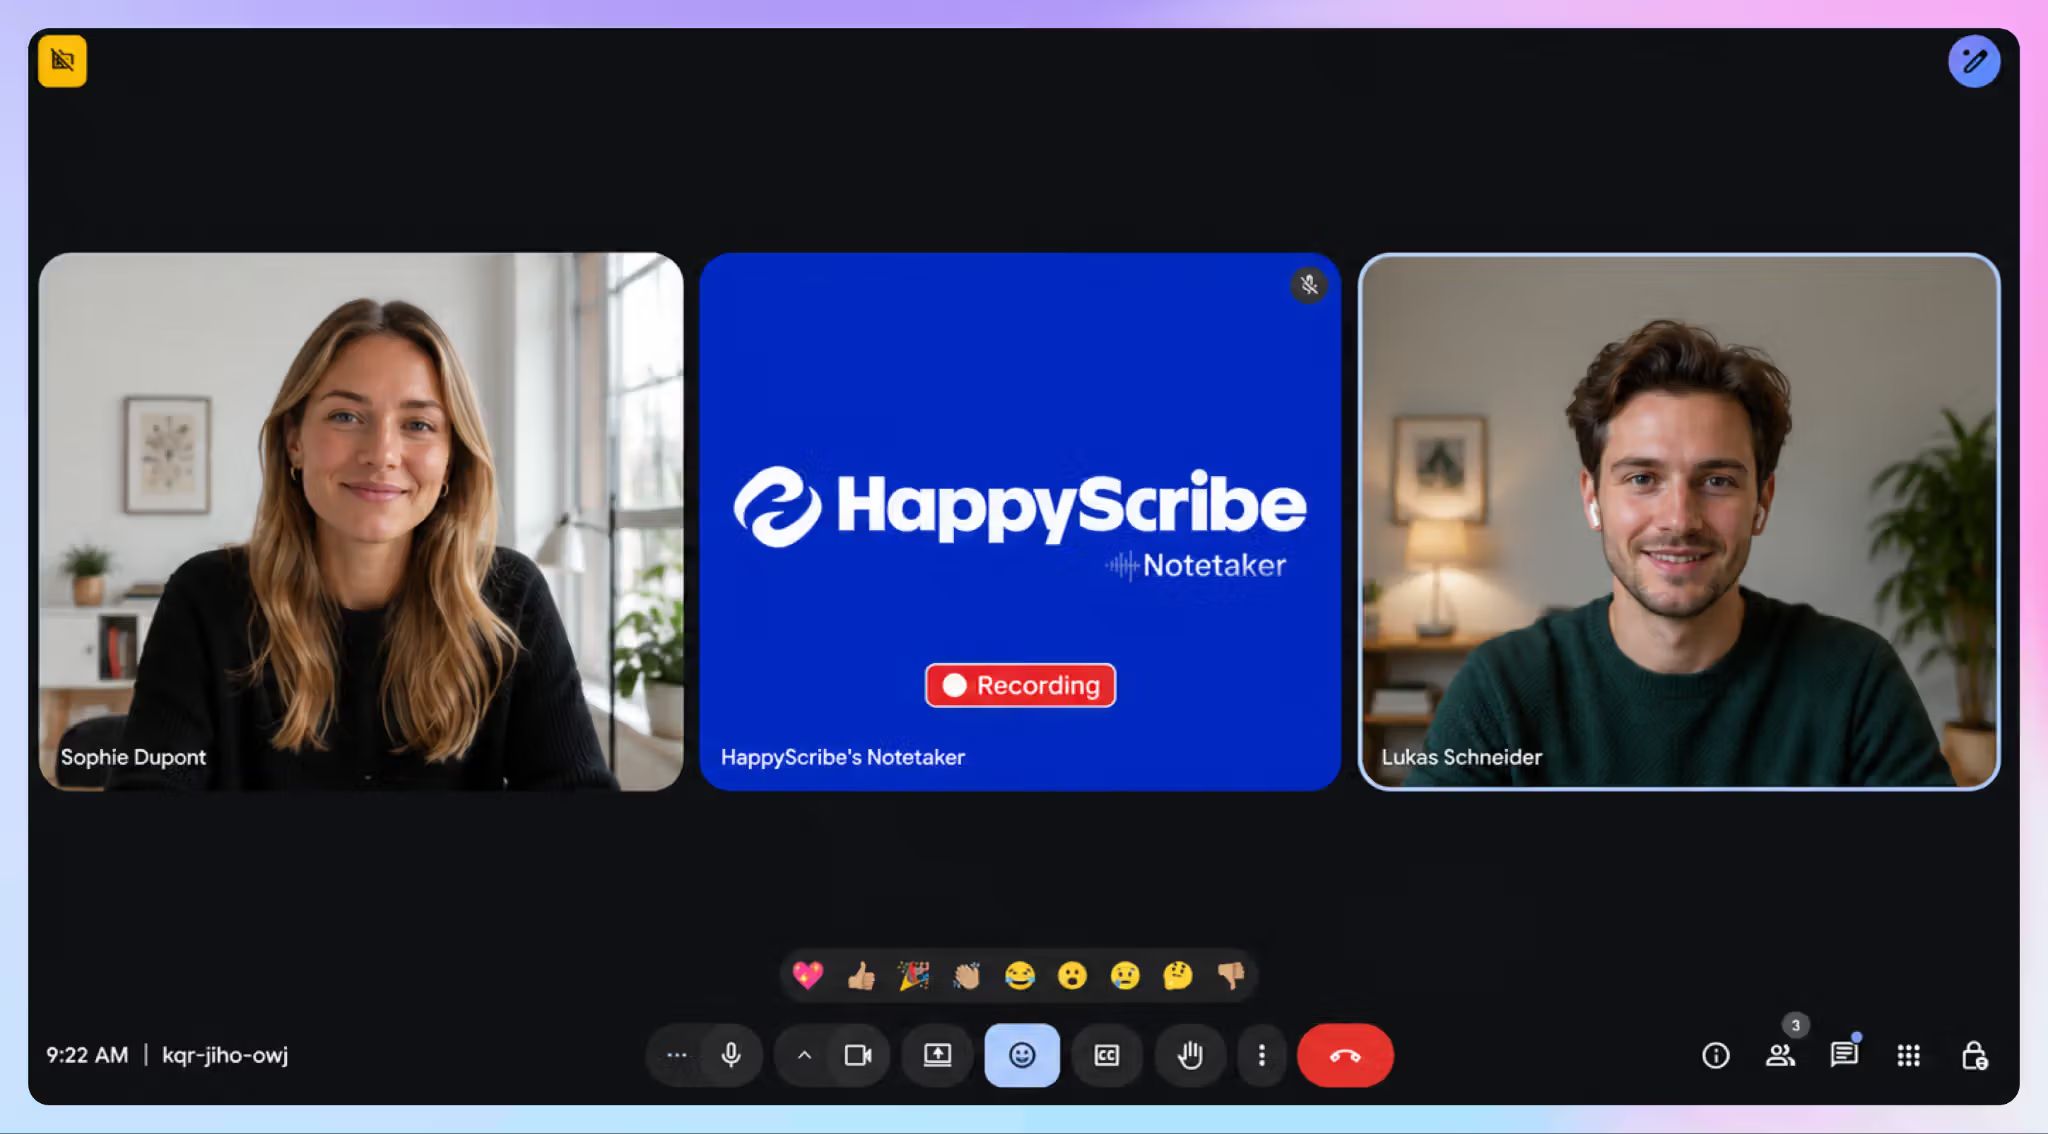
1. Koppel voor online vergaderingen je agenda, dan schuift de AI-notulist automatisch aan bij geplande gesprekken in Zoom, Google Meet of Microsoft Teams. Hij neemt op, transcribeert en ordent het resultaat helemaal zelf.
2. Voor fysiek veldwerk of spontane gesprekken neem je direct op met de mobiele app van HappyScribe. Al je veldbezoeken en contextual inquiries komen in hetzelfde account terecht als je online gesprekken.
3. Upload voor je backlog wat je al hebt. Je vult een nieuwe repository snel met gearchiveerde interviewopnames, en dit is meestal waar bureaus beginnen.
4. Je kunt ook importeren vanuit Google Drive, Box, Wistia, Dropbox, YouTube en Vimeo, wat opgenomen webinars dekt en alles wat een klant je toestuurt.
HappyScribe ondersteunt meer dan 150 talen en dialecten, en automatische transcriptie kun je upgraden naar professionele transcriptie wanneer de nauwkeurigheid een expertblik verdient.
Het doel van deze stap is simpel: laat klantbewijs niet langer verspreid over losse plekken staan.
Stap 2: Orden rond de vragen die je later gaat stellen
Nu heb je een stapel transcripties op één plek, maar ze gaan over verschillende projecten, doelen en afdelingen. De volgende stap is ze in mappen sorteren, zodat je Claude op een specifieke verzameling bewijsmateriaal kunt richten in plaats van op je hele account. Mappen zijn bovendien prettig overzichtelijk.
Zo orden je transcripties in mappen in HappyScribe:
- Op onderzoeksproject. Onboardingonderzoek, het prijsonderzoek, churn-interviews, discoveryrondes bij enterprise-klanten, enzovoort. Dit sluit aan op hoe het werk in de praktijk wordt uitgevraagd.
- Op klantsegment. MKB, mid-market, enterprise, academici, zorg, enzovoort. Handig als je weet dat je later groepen gaat vergelijken.
- Op productgebied. Activatie, samenwerking, rapportage, facturatie, zoeken, of waar je roadmap ook omheen is opgebouwd. Dit is de structuur waar PM's het meest aan hebben als ze maanden later iets komen vragen.
- Op periode. Kwartalen of onderzoeksrondes, zodat je ziet hoe hetzelfde patroon verschuift van de ene ronde naar de volgende.
Tags werken naast mappen. Je kunt zowel bestanden als mappen taggen en er vanuit je HappyScribe-dashboard op filteren om sneller te werken. Heb je te veel bestanden? Vraag Claude gewoon om mappen aan te maken en transcripties te verplaatsen.
Belangrijk om te weten: je mapmachtigingen in HappyScribe blijven gewoon gelden. Privémappen blijven privé en submappen erven de rechten van de bovenliggende map, dus Claude komt niet bij data waar jij dat niet wilt.
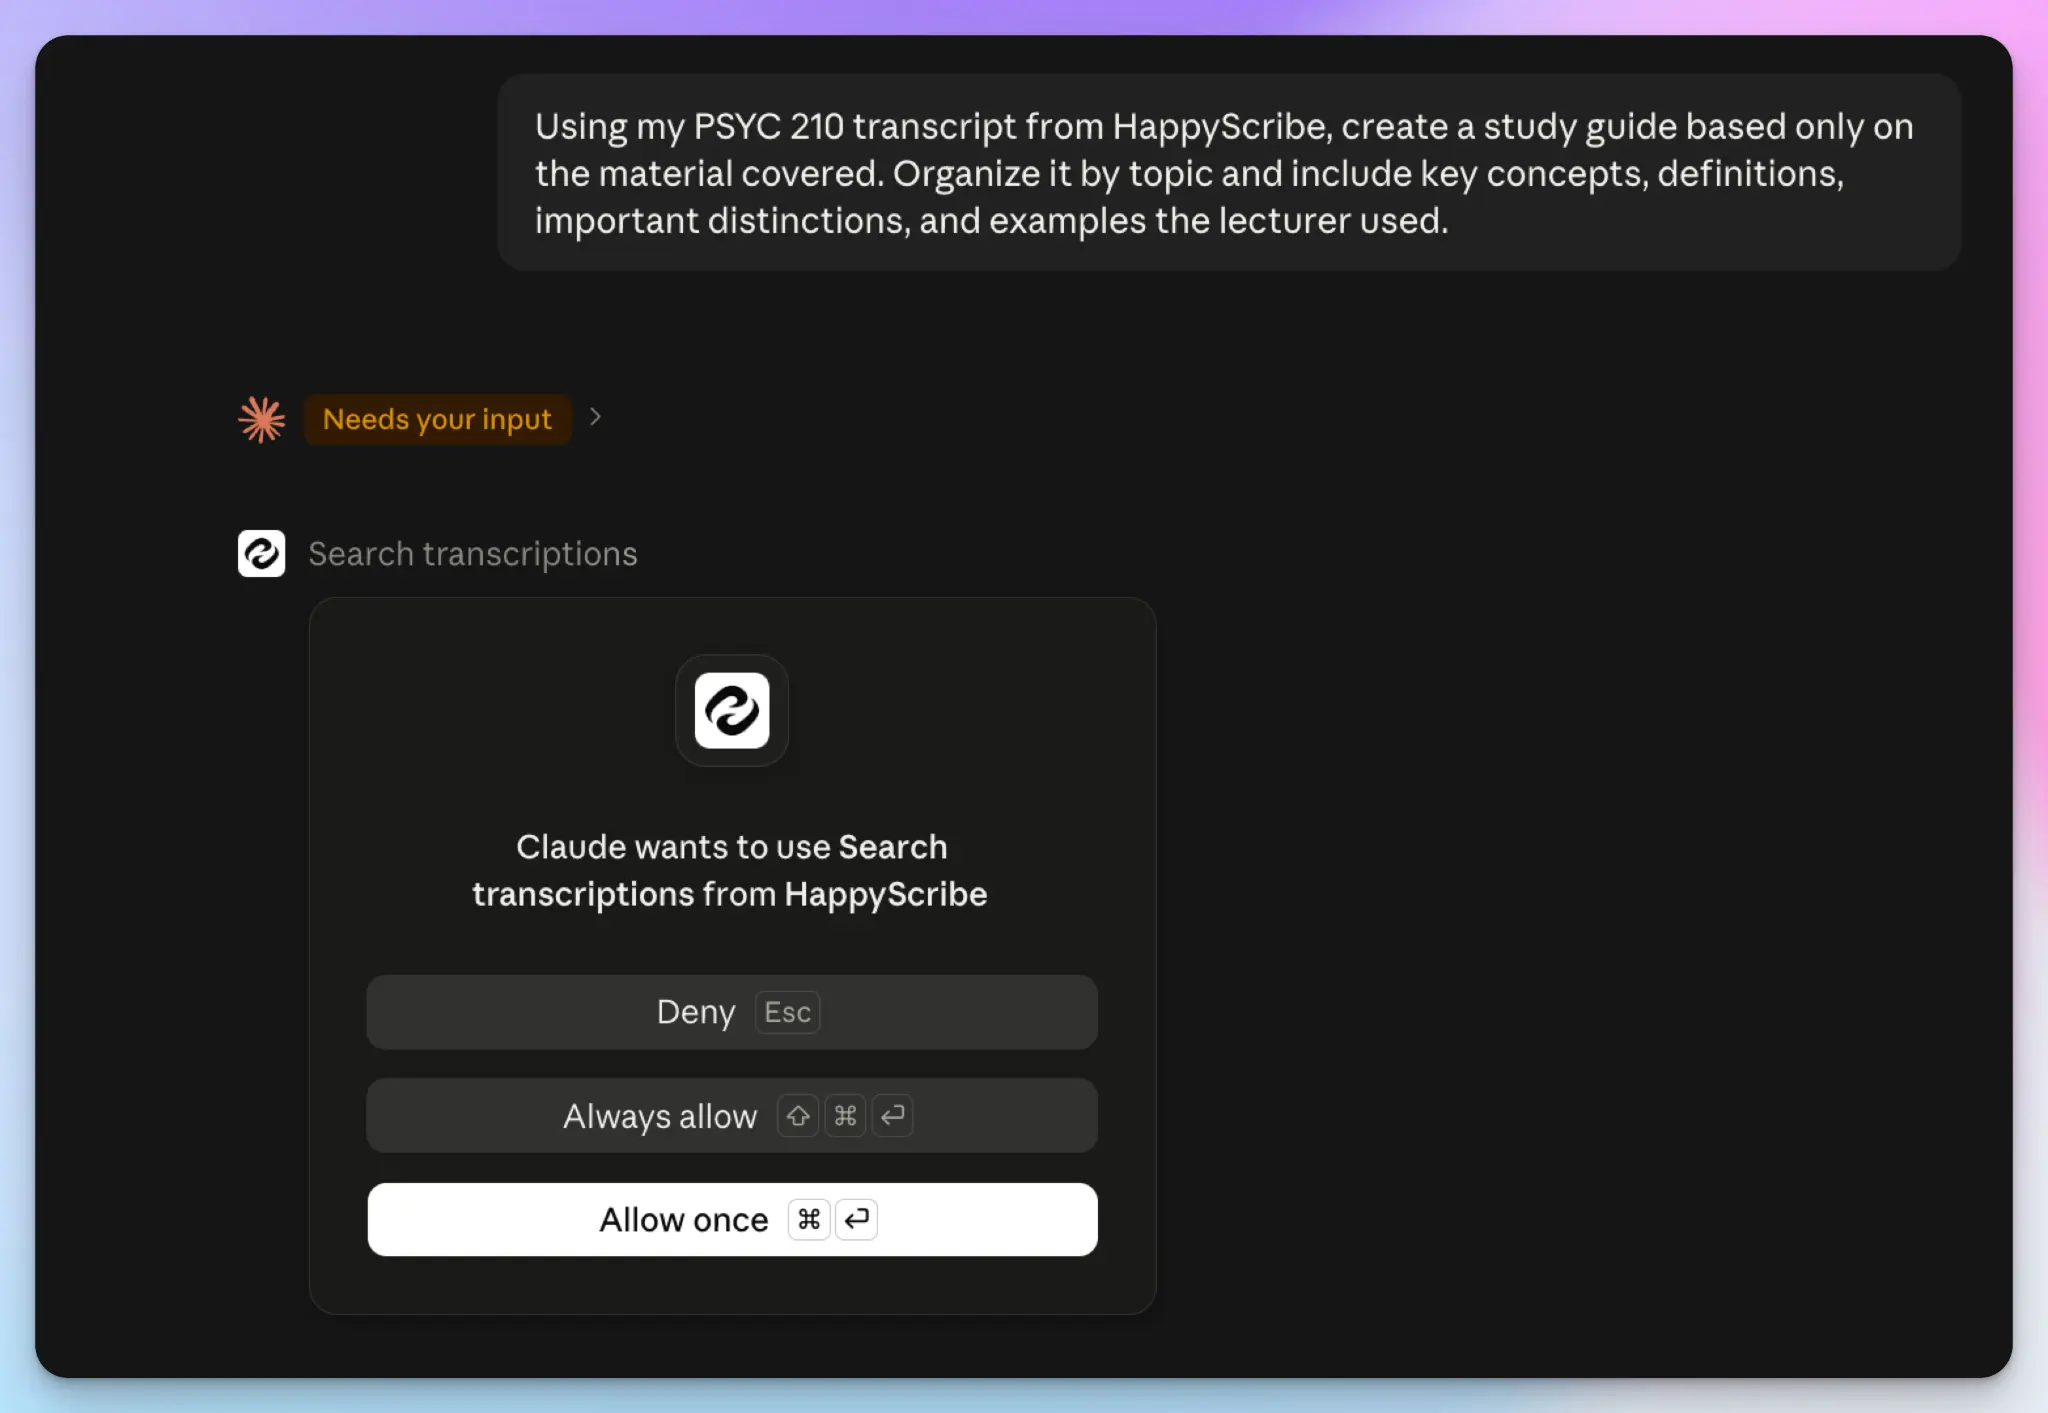
Stap 3: Koppel de repository aan Claude
Koppelen kost een paar minuten en hoeft maar één keer.
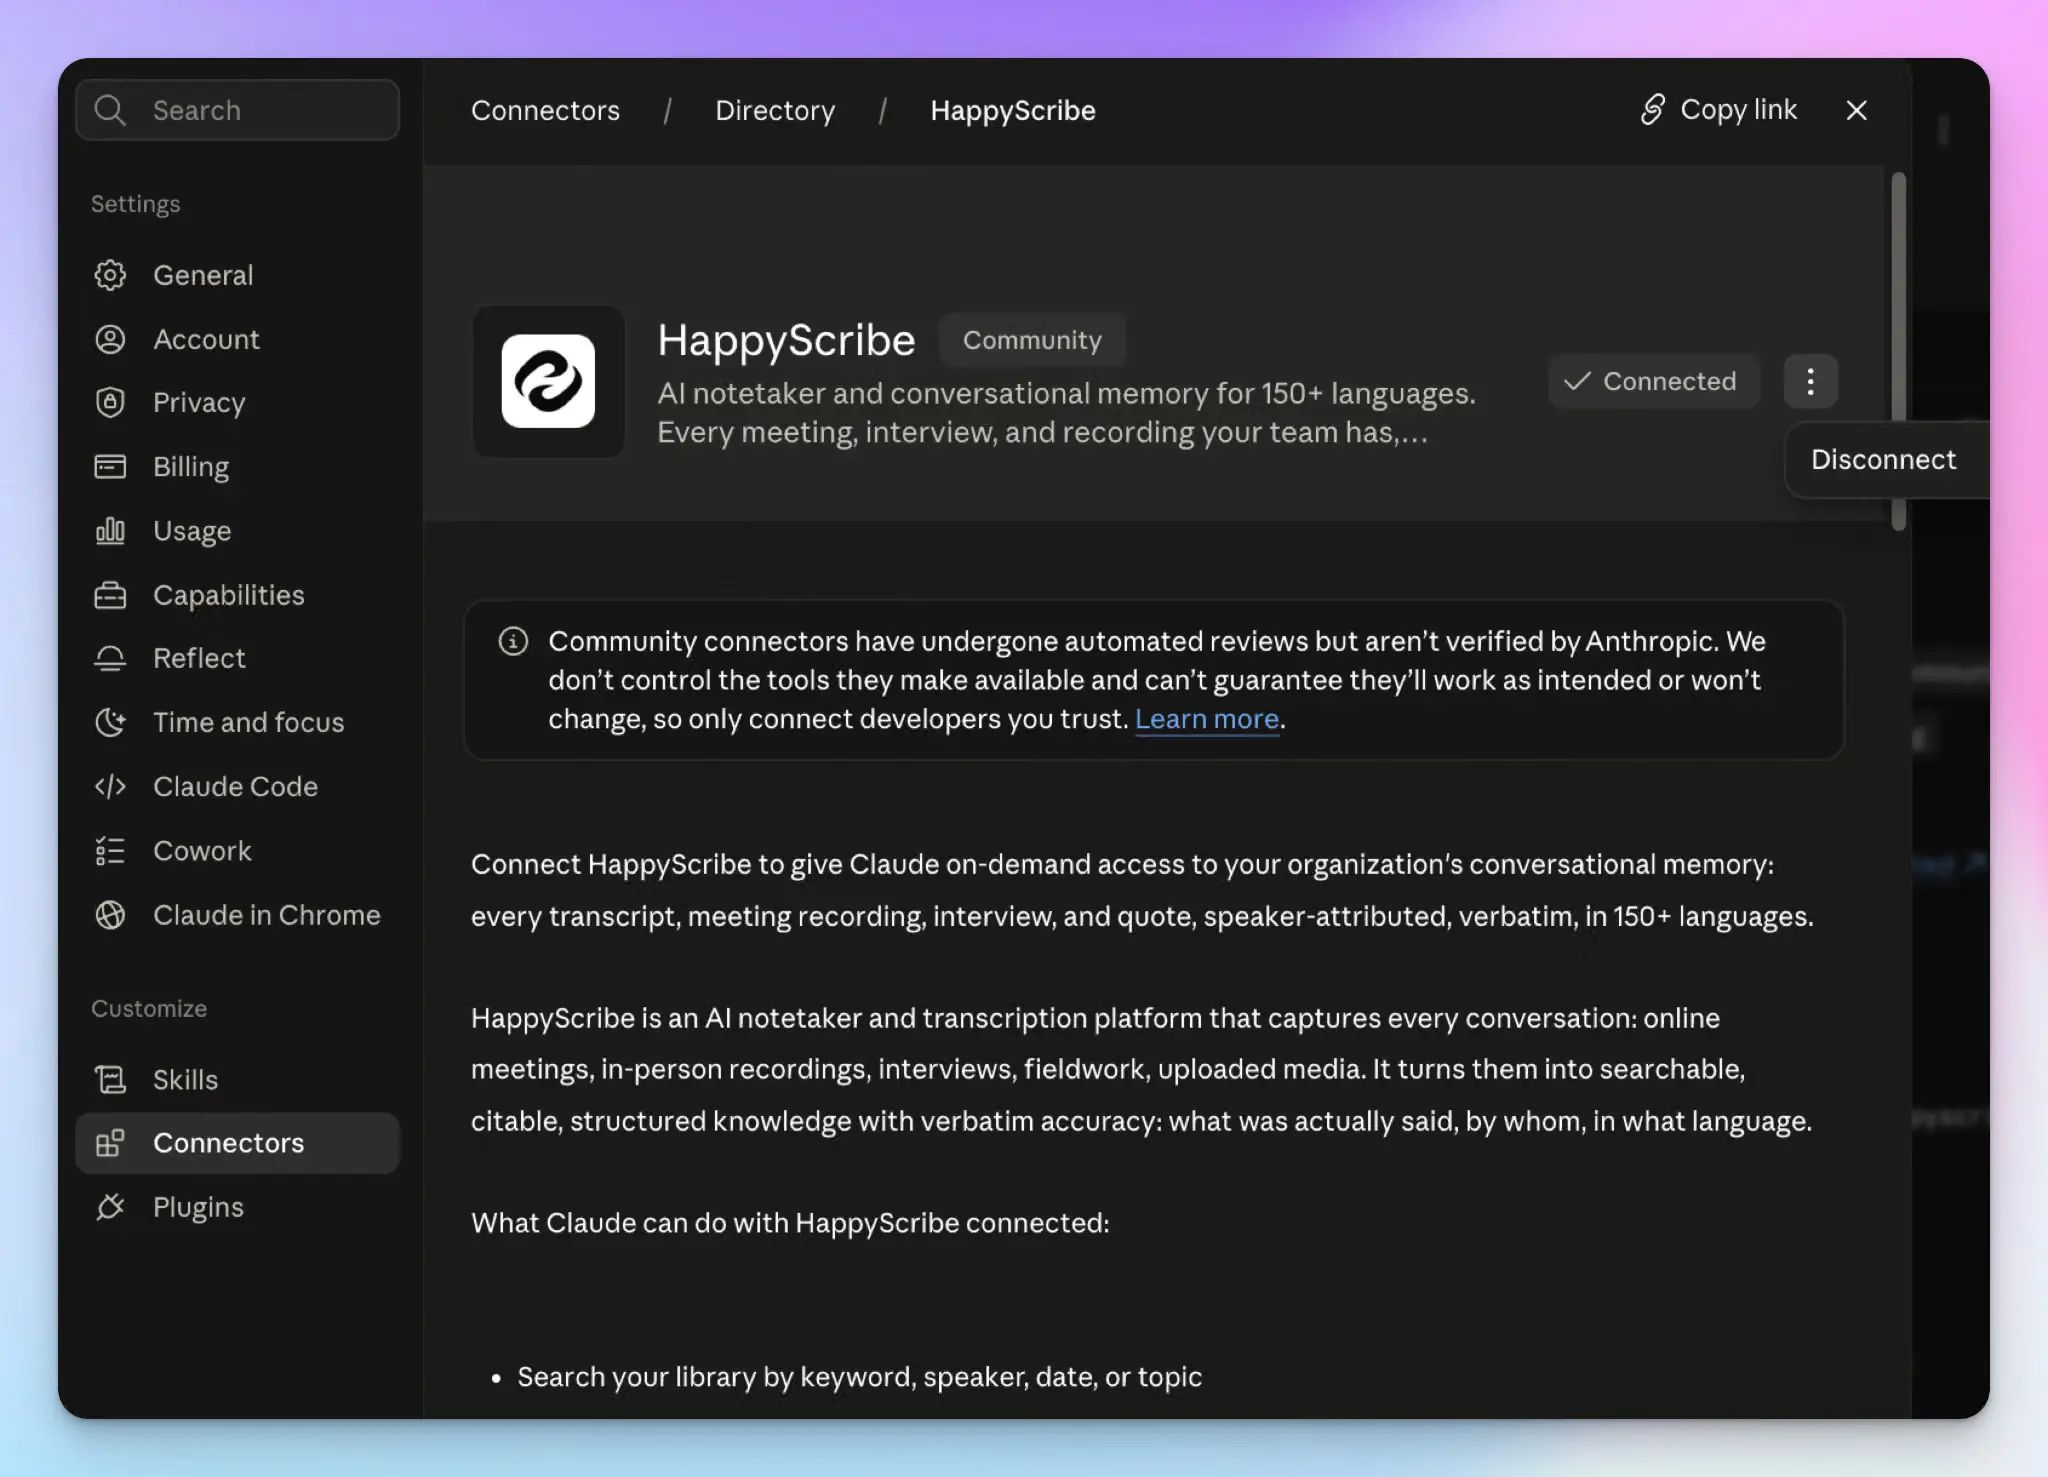
Vanuit Claude:
- Klap de linkerzijbalk uit en klik op Customize > Connectors.
- Zoek naar HappyScribe en klik op het +-icoon ofde Connect to Claude-knop.
- Log in op je HappyScribe-account en geef toegang.
Je kunt ook vanuit HappyScribe beginnen. Klik op Integraties in de linkerzijbalk, zoek de Claude-kaart en klik op Koppelen.
De Claude Desktop-app en Claude Code gebruiken dezelfde HappyScribe MCP-server, die je toevoegt via de ontwikkelaarsinstellingen of met één terminalcommando. Enterprise-beheerders kunnen de connector over een hele workspace uitrollen.
Zodra de koppeling staat, raadpleegt Claude je transcripties alleen als je erom vraagt. Er wordt niets vooraf gekopieerd en geen enkel onderzoek verlaat HappyScribe totdat een prompt erom vraagt.
Luister naar onze gebruikers die HappyScribe met Claude gebruiken:
Ik gebruik HappyScribe voor al mijn vergaderingen: om de sessies op te nemen, te notuleren, samenvattingen te krijgen en alles via hun MCP te koppelen aan mijn Claude-account. Ik vind het geweldig dat de transcripties in mijn taal (Bulgaars) accuraat zijn en me veel tijd besparen.
Stap 4: Stel vragen over je hele repository
Hier begint je repository zich terug te betalen. In plaats van te onthouden in welk interview een bepaalde opmerking viel, vraag je er gewoon om. Dit is alles wat HappyScribe aan Claude beschikbaar stelt:
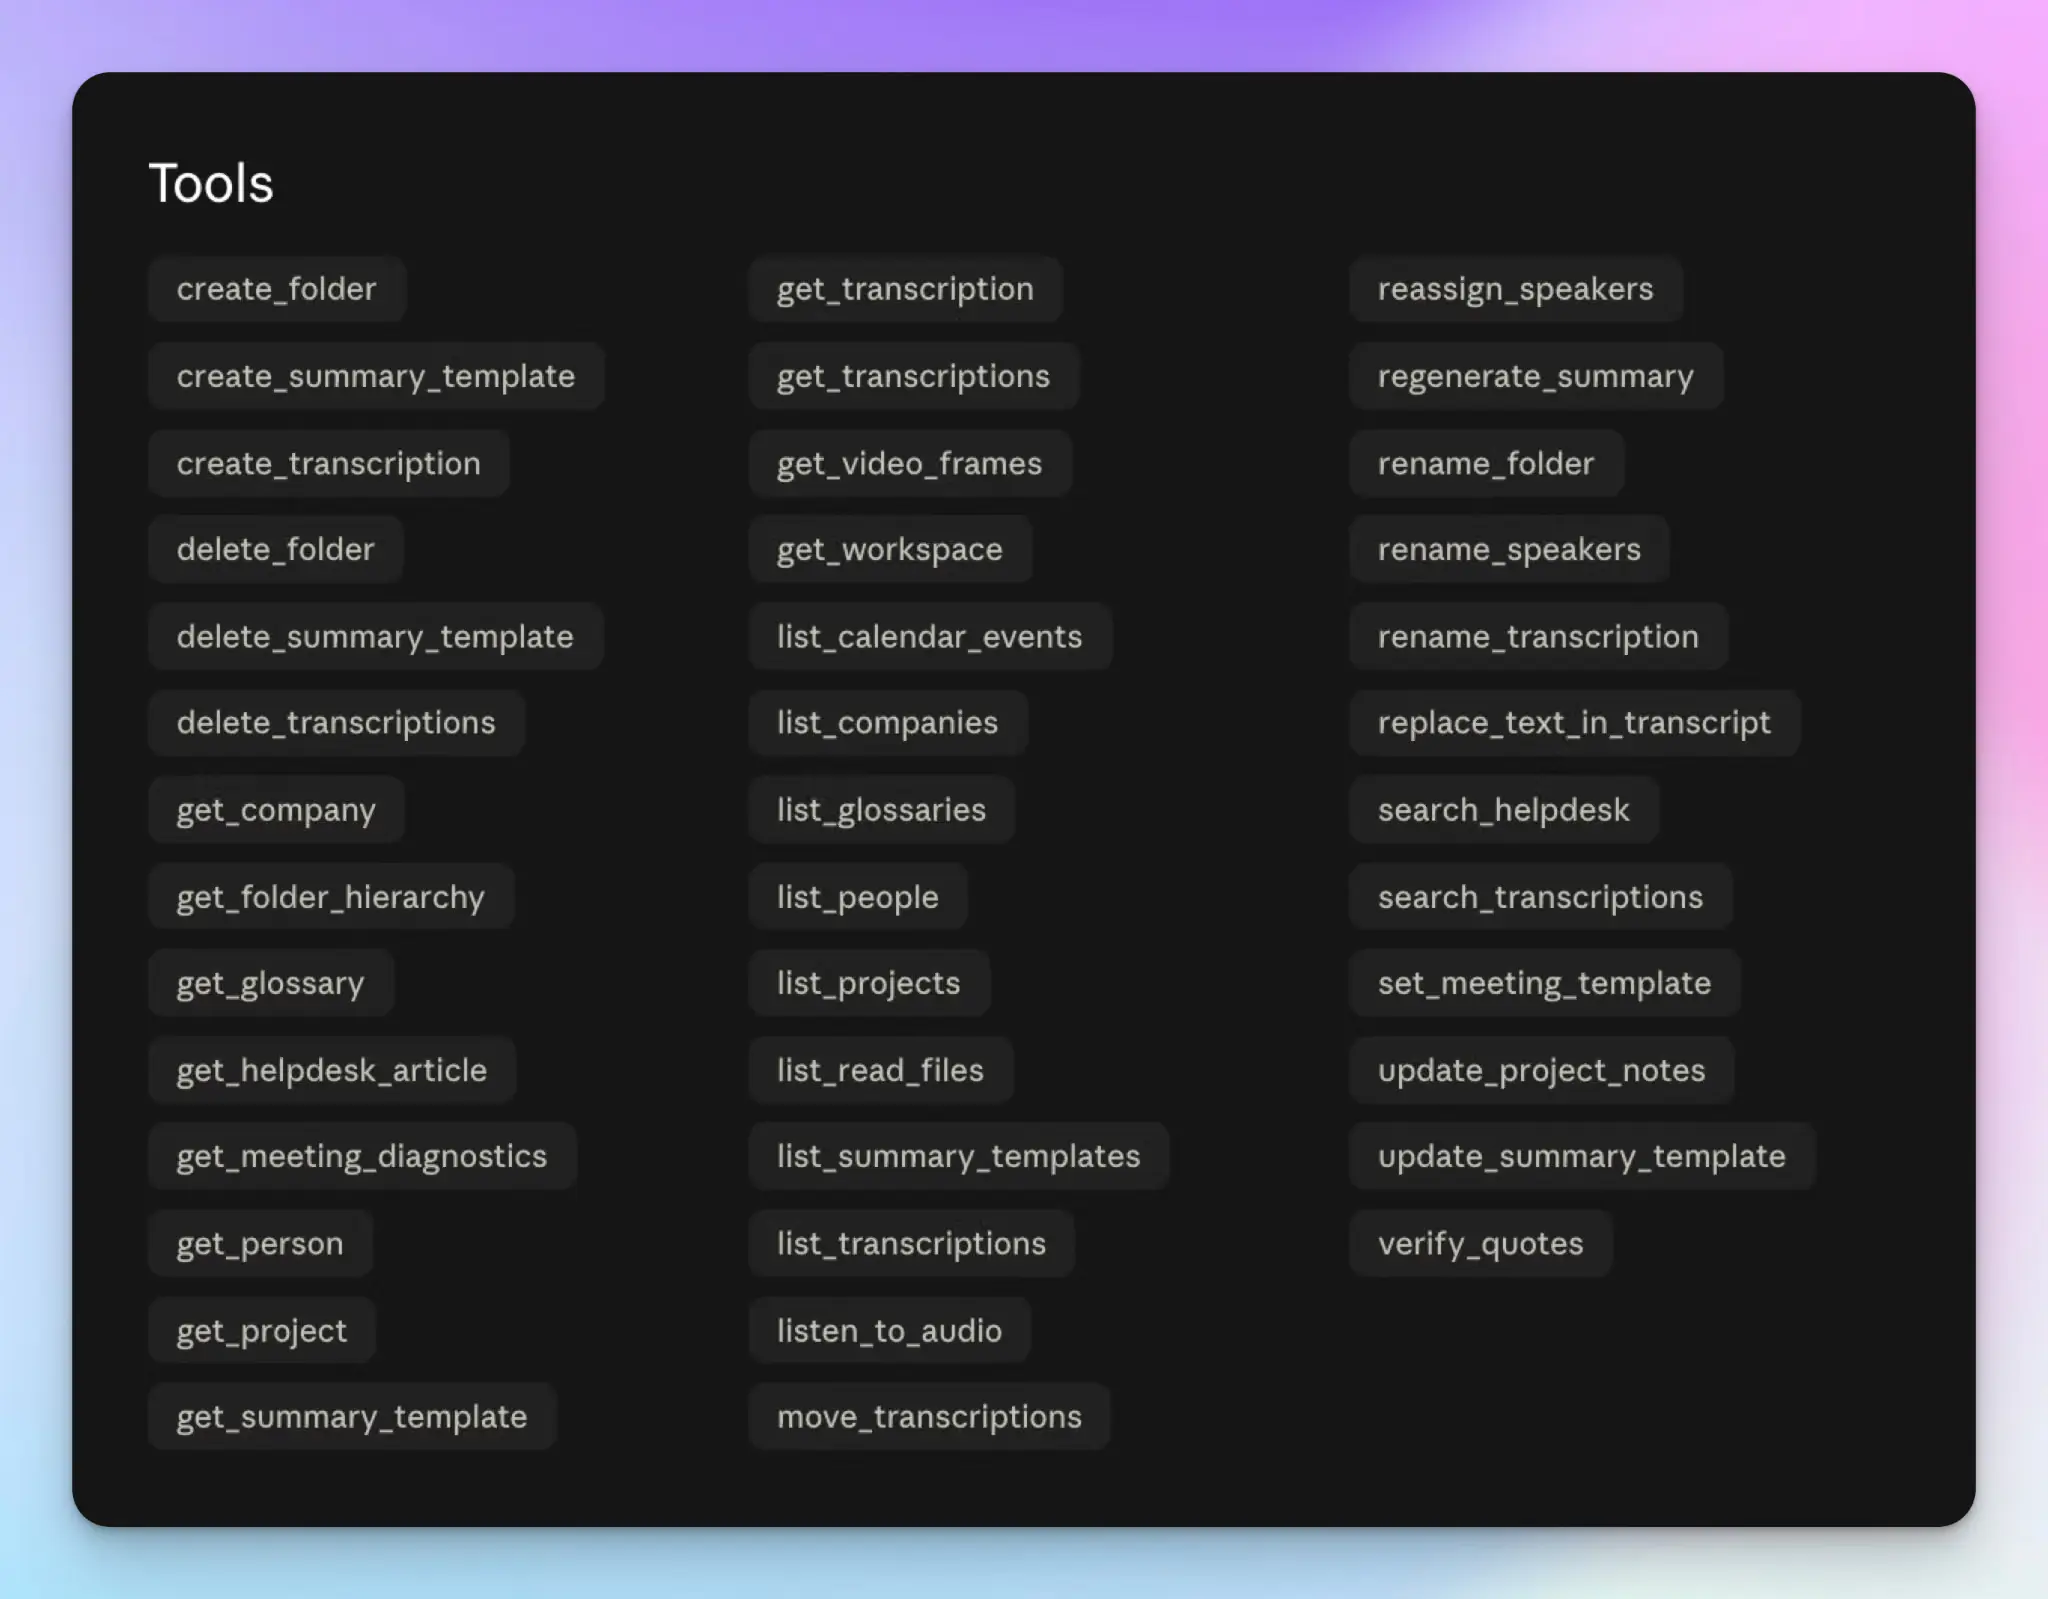
Begin met terugvinden. Claude kan de inhoud van transcripties doorzoeken zoals je een document doorzoekt, en filteren op wie erbij was en wanneer het gesprek plaatsvond:
Zoek interviews waarin klanten beschreven dat het inrichten van hun workspace lastig was.
In welke gesprekken van vorig kwartaal werden zorgen over de prijs geuit?
Laat me elke sessie zien waarin Joy M. de interviewer was.
Ga daarna verder dan alleen bestanden vinden. Dezelfde koppeling laat Claude een hele map doorlezen en vragen beantwoorden die geen enkele losse transcriptie kan beantwoorden:
Welke problemen kwamen in de onboardinginterviews in deze map in meer dan één sessie terug?
Welke redenen gaven opgezegde klanten voor hun vertrek?
Welke bezwaren kwamen het vaakst terug in onze discovery calls?
Product- en klantteams waren vroeger weken kwijt aan die tweede reeks. Je moest transcripties coderen, citaten per thema taggen en tellen hoe vaak iets terugkwam; allemaal met de hand. Claude doet de eerste ronde in minuten.
Zo haal je ook eenvoudig data eruit. Vraag om de functieverzoeken in een tabel met de deelnemer en de datum van de sessie, en je hebt meteen iets dat je aan je manager kunt geven.
Gebruikers waarderen het gemak van HappyScribe + Claude:
De native Claude-integratie via MCP is de reden dat we voor HappyScribe hebben gekozen, en het is sneller een dagelijkse gewoonte geworden dan ik had verwacht. Ik vraag Claude met mijn stem, via mijn koptelefoon tijdens het wandelen, wat ik in ons laatste gesprek met een partner had toegezegd — geen getyp, geen gespit in notities.
Stap 5: Bouw thema's op met het bewijs er nog aan vast
In hetzelfde onderzoek van User Interviews dat ik eerder noemde, zei 91% zich zorgen te maken over de nauwkeurigheid van de output en over hallucinaties. Onderzoekers hebben gelijk dat ze huiverig zijn voor een thema dat plausibel klinkt maar nergens op terug te voeren is.
De oplossing: laat een bevinding nooit rondgaan zonder het bijbehorende bewijs. Vraag in dezelfde prompt om allebei:
Identificeer de terugkerende onboardingproblemen in deze interviews. Voeg per thema ondersteunende citaten met tijdcodes toe en noem welke deelnemers het zeiden.
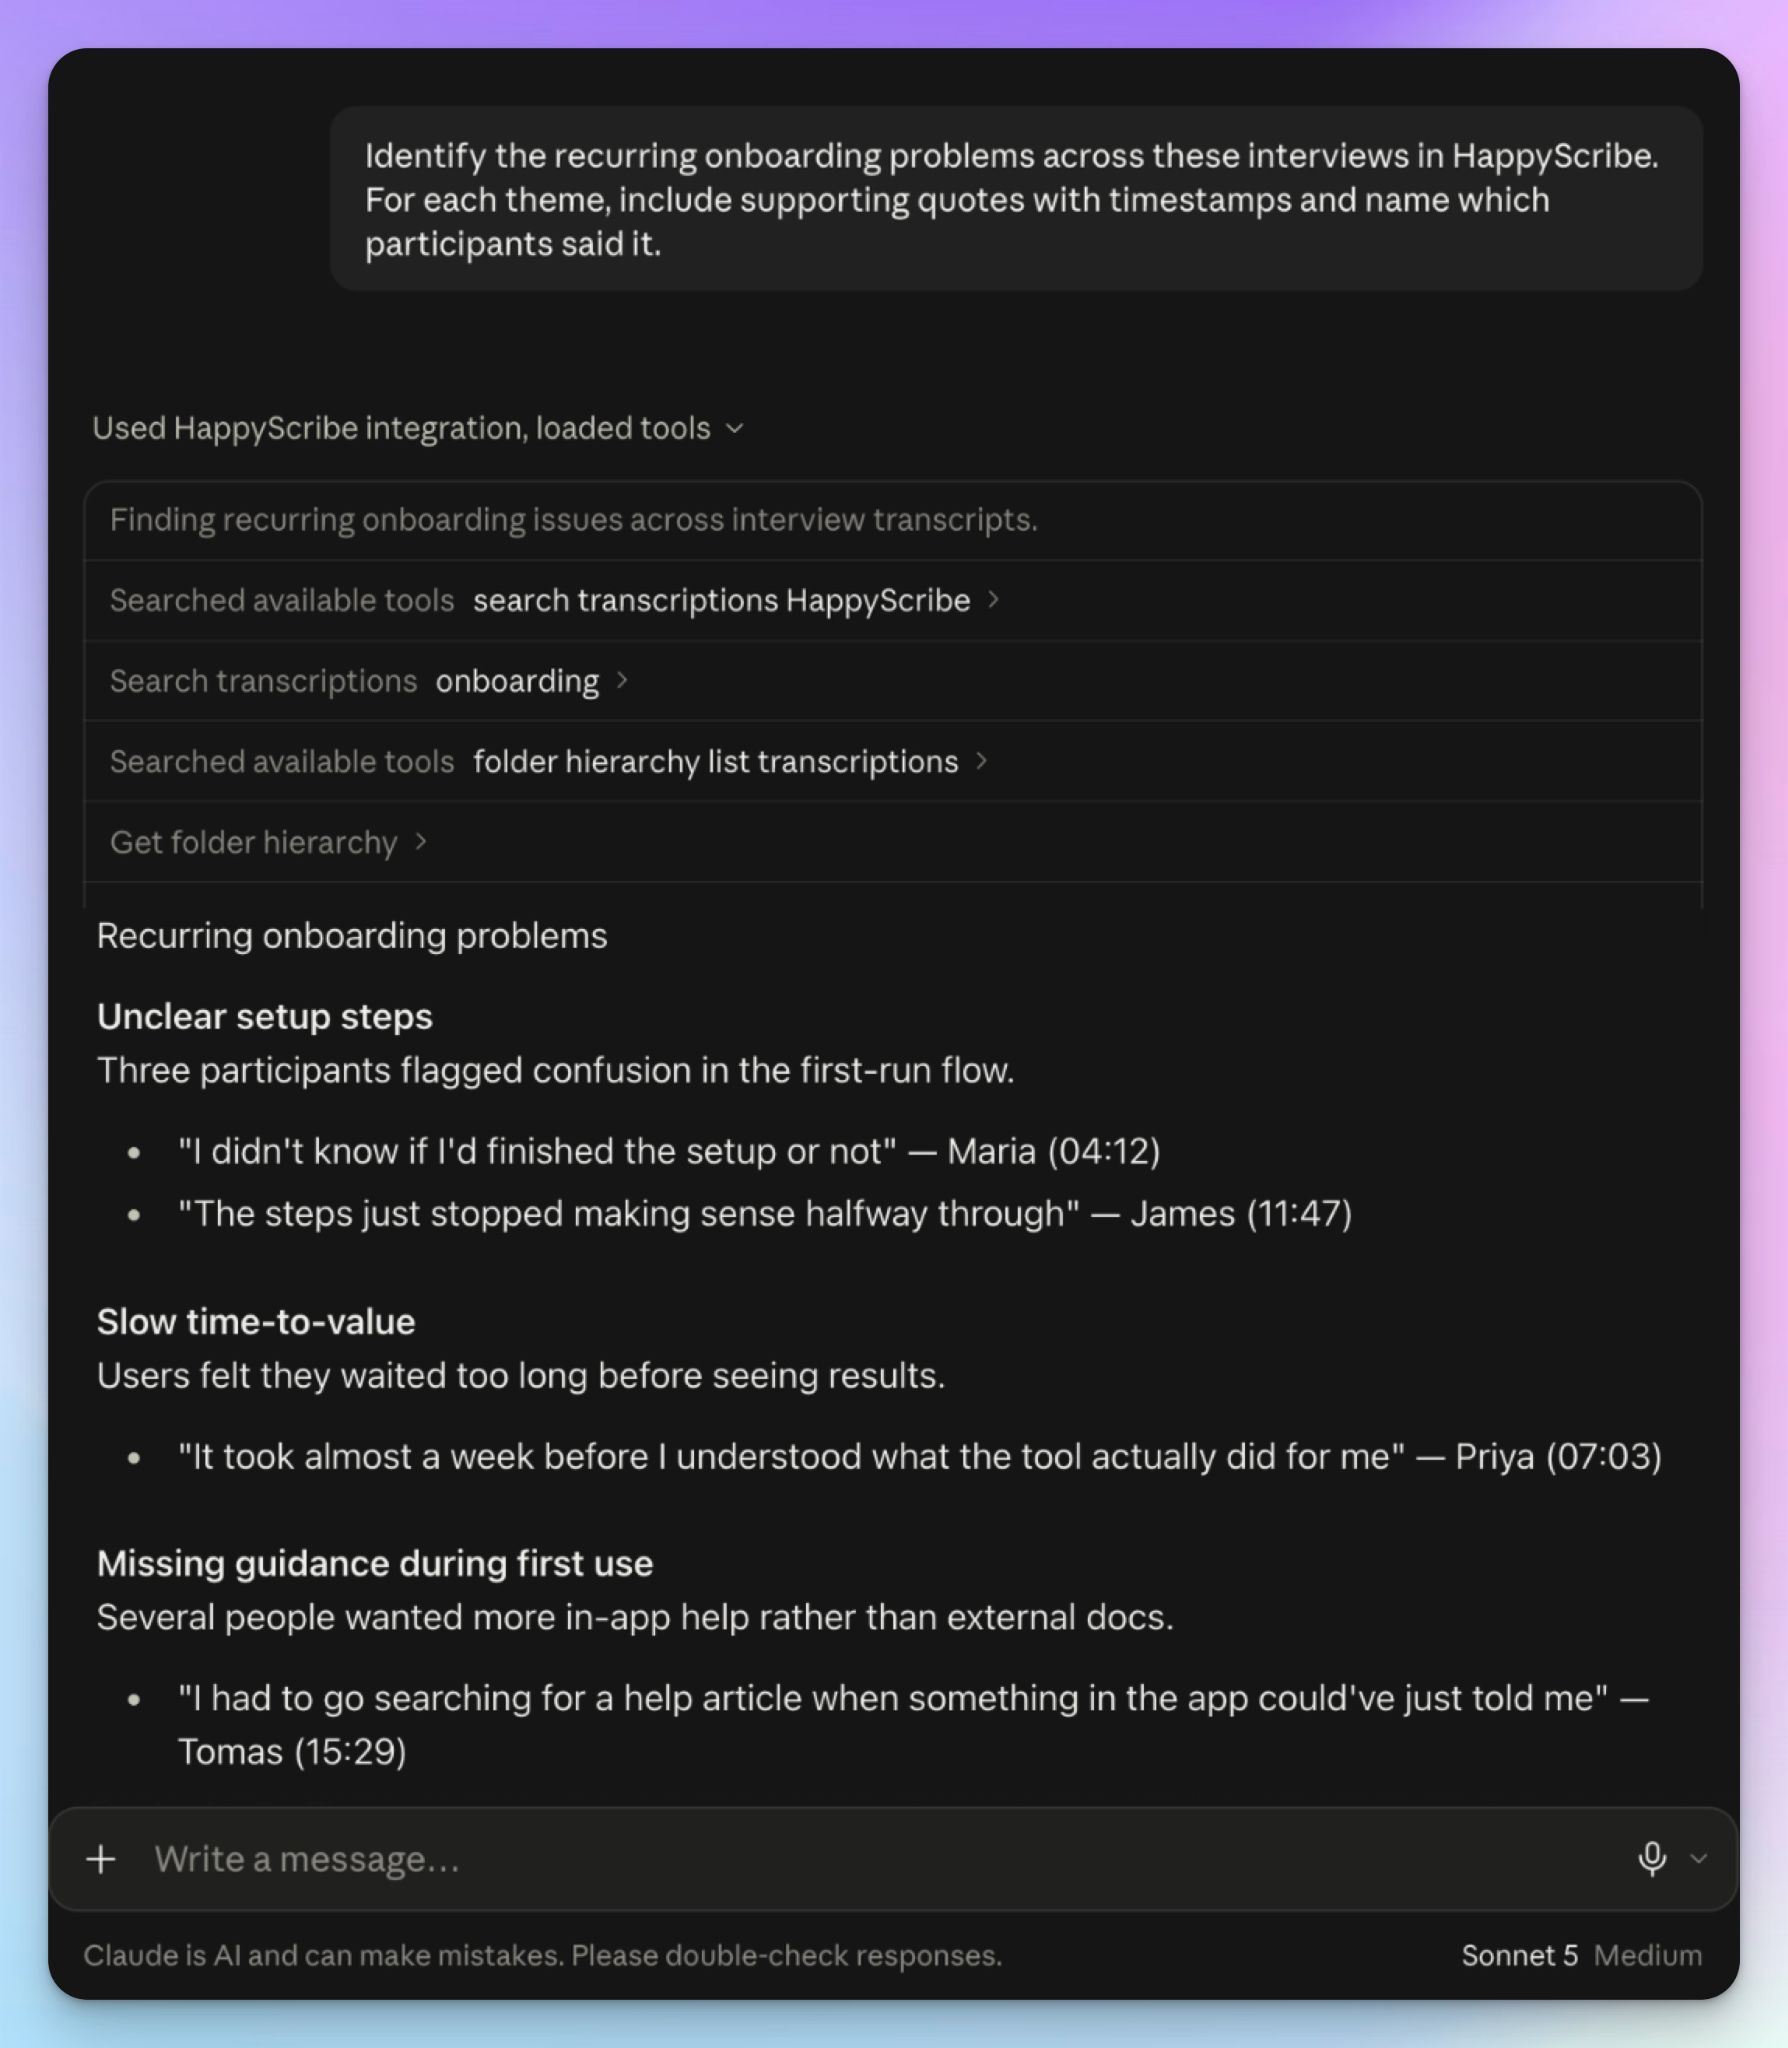
Claude geeft exacte citaten met tijdcodes terug, plus links naar de HappyScribe-editor, zodat elke bewering met één klik te controleren is. Je hoort de toon, de aarzeling en de vraag die eraan voorafging.
Doorloop daarna deze lus: thema benoemen > bewijs opvragen > het citaat openen > bevestigen dat het betekent wat het thema beweert.
Die laatste stap is aan jou. Claude groepeert wat op elkaar lijkt, en jij bepaalt of twee klanten die het over een "verwarrende setup" hebben hetzelfde probleem beschrijven of twee verschillende.
Stap 6: Zet gevalideerde bevindingen om in deliverables
Pas nu heeft het zin om Claude iets te laten schrijven. Houd de juiste volgorde aan: vraag > bewijs > synthese > jouw validatie > deliverable. Sla je door naar de deliverable, dan krijg je gepolijst proza dat op ongecontroleerde groeperingen rust.
Zodra de bevindingen standhouden, levert dezelfde koppeling:
- Onderzoeksrapporten met citaten en tijdcodes er al aan vast
- Voice-of-customer-samenvattingen voor teams die het volledige rapport toch niet lezen
- Briefings over productkansen die aansluiten op wat klanten echt hebben gezegd
- Stakeholder-updates die antwoord geven op de vraag die iemand in een vergadering stelde
- Citatenverzamelingen voor messaging, productpagina's of een salesdeck
Vraag om het formaat dat je nodig hebt. Omdat het bewijs al aan de bron vastzit, is de output goed genoeg om beslissingen op te baseren.
Vragen die je je repository moet stellen
Met de stappen hierboven werkt je repository. Hier zijn een paar vragen waarmee je er het meeste uit haalt:
Toets een hypothese aan het bewijs
Teams discussiëren voortdurend over aannames. Met een repository check je er één voordat de discussie verder woekert.
Wij denken dat de complexiteit van de setup onze grootste activatiedrempel is. Wat in deze interviews ondersteunt dat, en wat spreekt het tegen?
Vergelijk klantgroepen
Als je steeds op geaggregeerde thema's blijft leunen, bouw je een gemiddelde klant die niet op je gebruikersbestand lijkt.
Hoe beschrijven enterprise-klanten dit probleem anders dan MKB-klanten?
Dit werkt alleen als het onderscheid in je mappen zit of in wat deelnemers hebben gezegd, dus segmenteer vroeg als je weet dat je dit later nodig hebt.
Zoek wat het dominante thema tegenspreekt
Consensus is makkelijk te vinden, maar kan ook misleidend zijn. Met tegenstrijdig bewijs neem je slimmere productbeslissingen.
De meeste deelnemers zeiden dat de onboarding moeilijk was. Zoek de interviews die dat tegenspreken en leg uit wat er anders was aan die klanten.
Volg hoe feedback in de loop van de tijd veranderde
Vergelijk de onboardingklachten uit Q1 met onze meest recente interviews. Wat is verstomd en wat is nieuw?
Dit is de beloning voor het bewaren van de brongesprekken in plaats van elk onderzoek als eenmalig te behandelen. Het vertelt je ook of de oplossing die je vorige ronde uitbracht echt heeft gewerkt.
Volg één klant door alle gesprekken heen
HappyScribe bouwt een knowledge graph van de mensen en bedrijven die in je transcripties voorkomen, zodat de geschiedenis van een klant over losse sessies heen terug te vinden is.
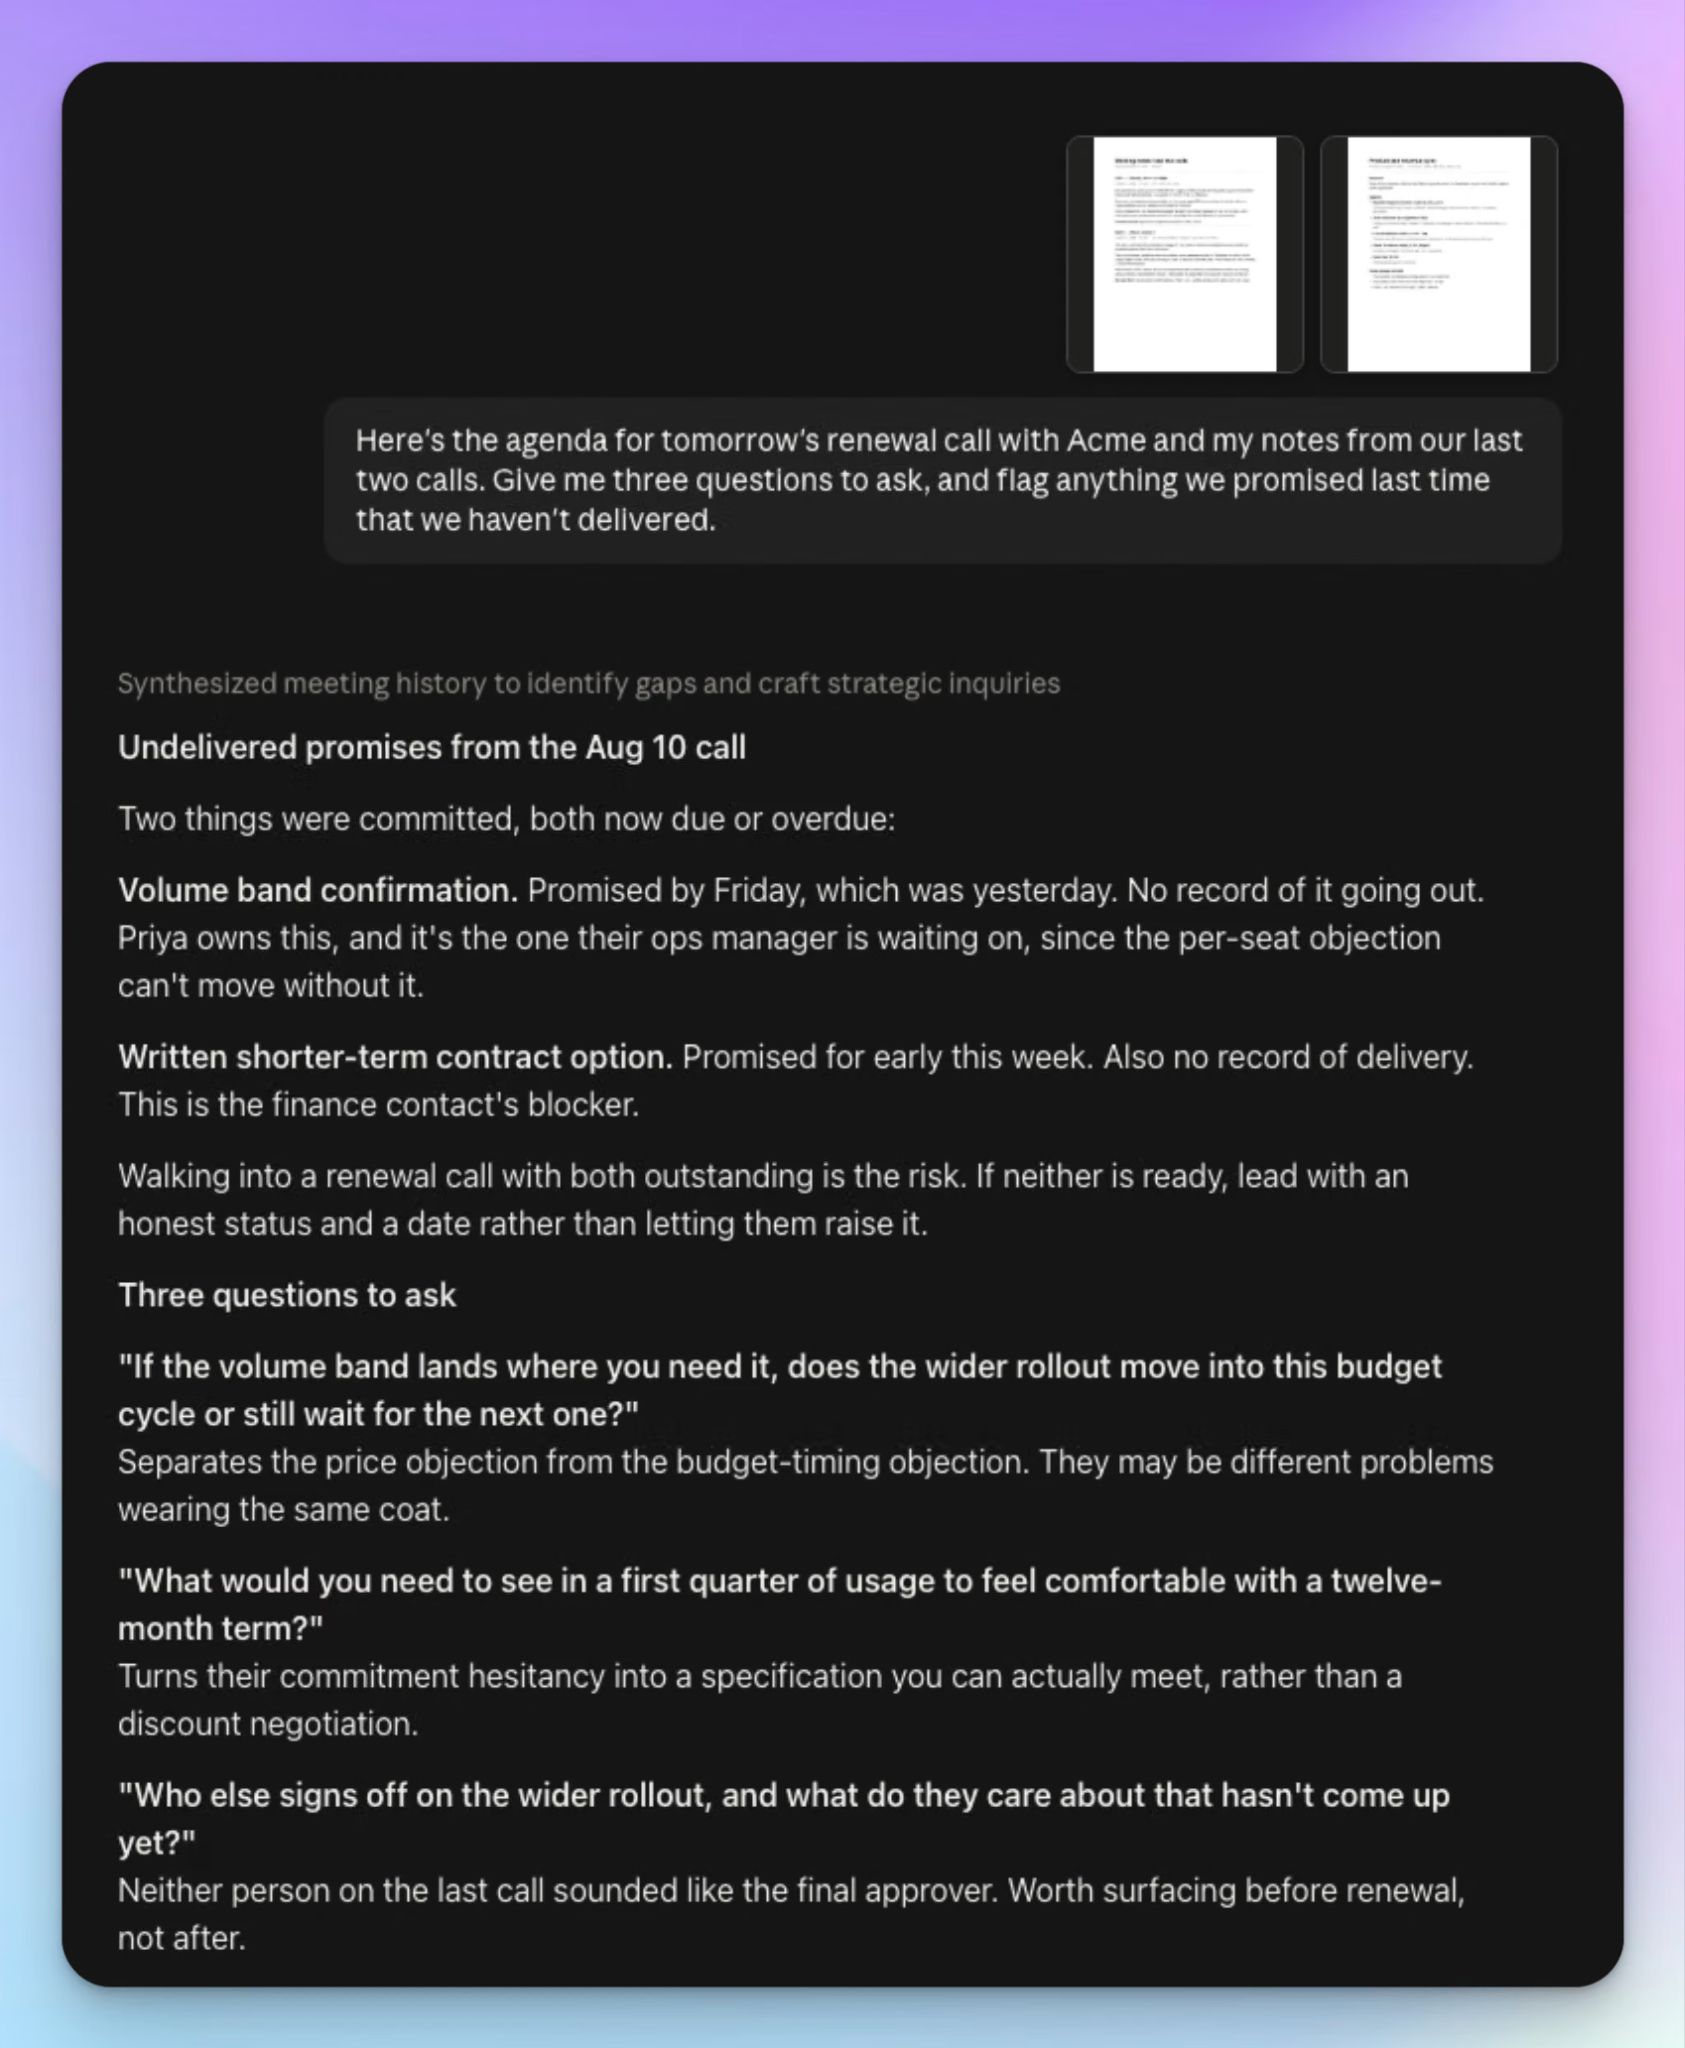
Wat heeft Acme in al onze gesprekken over de implementatie gezegd, en hoe zijn hun prioriteiten verschoven?
Handig voor verlengingen en QBR's, al is het een ingang tot je eigen onderzoeksmateriaal en geen CRM.
Je repository betrouwbaar houden
Omdat een repository klantgesprekken op één plek samenbrengt, moet je extra goed opletten hoe je ermee omgaat.
Vraag toestemming tijdens de sessie, niet achteraf. Vertel deelnemers dat het gesprek wordt opgenomen en getranscribeerd, en zeg er duidelijk bij of een AI-assistent het gaat analyseren.
Let op wat er in de transcripties staat. Kwalitatieve onderzoeksinterviews leggen namen, werkgevers, accountgegevens en af en toe iets vast wat een deelnemer niet had willen delen. In de editor van HappyScribe haal je die eruit voordat het bestand deel wordt van de doorzoekbare repository, en geanonimiseerde transcripties kun je veiliger met een bredere groep delen.
HappyScribe draait op enterprise-grade beveiliging met AVG en SOC 2 Type II-compliance en EU-hosting, en daarom gebruiken juridische, academische en salesteams het voor werk dat niet op een algemene drive mag staan.
Als dit allemaal staat, regel je de gebruikerstoegang. Niet iedereen die profiteert van de bevindingen hoeft bij de ruwe sessies te kunnen, en met mapmachtigingen trek je die grens. Enterprise-beheerders kunnen dit op workspace-niveau instellen.
Een repository voor klantonderzoek wordt waardevoller naarmate hij groeit
Elk interview dat je toevoegt maakt de volgende vraag makkelijker te beantwoorden, en je hoeft de context niet opnieuw op te bouwen zodra er een nieuwe vraag opduikt. Met Claude en HappyScribe maak je markt- en productonderzoek een stuk werkbaarder.
Veelgestelde vragen over het bouwen van een repository voor klantonderzoek met Claude
Kan Claude meerdere interviewtranscripties tegelijk analyseren?
Ja, maar niet met kopiëren en plakken. Plakken werkt voor een handvol interviews en loopt daarna vast, en daarom heeft Claude MCP-integraties nodig voor grote onderzoeksrepository's. Zodra HappyScribe gekoppeld is, wijs je Claude een map aan en doorzoekt hij elke transcriptie daarin. Ook data eruit halen wordt eenvoudiger: vraag om de pijnpunten die klanten het vaakst noemden in een tabel, met de deelnemer en de datum van de sessie in elke rij.
Heb ik Claude Code nodig om een repository voor klantonderzoek te bouwen?
Nee. De meeste onderzoekers hebben het nooit nodig. De connector regelt zoeken en synthese zelf. Claude Code helpt als je een herhaalbare workflow wilt in plaats van een eenmalig antwoord, en je hoeft geen developer te zijn om het te gebruiken. Met vibe coding beschrijf je in gewone taal wat je wilt, en schrijft Claude het script. Vervolgens voert het meerstapstaken zelfstandig uit op je eigen machine en levert het gestructureerde CSV-bestanden op met een betrouwbaarheidsscore voor elke bevinding. Dat is het meest waardevolle gebruik: codeer de extractie één keer en draai hem opnieuw op de volgende ronde interviews.
Wat is het verschil tussen Claude Projects en de HappyScribe-connector?
Projects geven je blijvende context binnen één project. Je uploadt bestanden één keer, en de projectinstructies nemen je onderzoeksopzet en inclusiecriteria mee naar elke nieuwe chat, zodat je de achtergrond niet steeds opnieuw hoeft uit te leggen. Maar je verplaatst nog steeds bestanden naar binnen, of dat nu vanaf je desktop of vanuit Google Drive is, en in één gesprek past maar een beperkte hoeveelheid. De connector schrapt die stap door de transcripties te raadplegen waar ze al staan.
Kan Claude Cowork helpen bij onderzoekssynthese?
Ja. Cowork is gemaakt voor kenniswerkers met meerstapstaken in plaats van één losse vraag. Wijs Cowork een onderzoeksmap aan en het haalt de thema's eruit, verzamelt de ondersteunende citaten en maakt er in één keer slidedecks of een geschreven verslag van. Gebruik Claude Opus voor de synthese zelf, waar redeneren over tegenstrijdig bewijs het zwaarst weegt.
Hoe voorkom je dat Claude citaten verzint in je onderzoeksanalyse?
Vraag in dezelfde prompt om het bewijs als om de bevinding. Vraag per thema om ondersteunende citaten met tijdcodes, open er daarna één of twee en controleer of ze betekenen wat het thema beweert. Dit werkt hetzelfde voor klantinterviews, een literatuuronderzoek of een gedeeld archief dat je onderzoeksgroep bijhoudt. AI-tools groeperen wat op elkaar lijkt; jij bepaalt of dat klopt. Die controle is wat output verandert in bruikbare inzichten.

Biplab Mazumder
Biplab is a content marketer and writer who helps high-growth brands scale content visibility across AI search channels. His works have been published in HubSpot, Freshworks, Atlassian, SurferSEO, etc. When he's not planning content strategy, he's testing AI content workflows and use cases.