TL;DR ⏩
- Alles an einem Ort erfassen. Interviews, Discovery-Calls und Kündigungsgespräche landen über den AI Notetaker, die Mobile App, Datei-Uploads oder Link-Importe alle in HappyScribe
- Nach Ordnern organisieren. Sortieren Sie Transkripte nach Projekt, Segment oder Produktbereich, damit Sie Claude auf einen klar abgegrenzten Bestand an Belegen ansetzen können
- Den HappyScribe-Connector in Claude verbinden. Fragen Sie über die Ordner hinweg, um Muster zu finden, Kundengruppen zu vergleichen und Hypothesen an Interviews zu prüfen
- Belege immer mitliefern. Claude liefert Zitate mit Zeitstempeln, sodass sich jedes Thema bis zur Quelle zurückverfolgen lässt, bevor es in ein Ergebnisdokument wandert
„Ich habe alle Kundengespräche und Erkenntnisse von vor Monaten sofort griffbereit“, sagte noch nie ein Researcher.
Sie wissen, dass das Kundenfeedback existiert. Aber die Daten des letzten Quartals zu ordnen und in einer Minute zu präsentieren, ist eine Plackerei.
Fast die Hälfte der Researcher (49 %) gab gegenüber User Interviews an, dass sie die Zukunft der UX-Forschung negativ sehen – ein Sprung um 26 Punkte innerhalb eines Jahres. Gleichzeitig setzen 80 % inzwischen irgendwo in ihrer Research-Arbeit KI ein.
Bei so vielen Veränderungen in der Branche wollen Sie die Belege nicht verlieren, für die Sie bereits hart gearbeitet haben.
Hier ist die Lösung: Bauen Sie das Repository für Kundenforschung in HappyScribe auf und setzen Sie Claude obendrauf. Die beiden wirken vielleicht wie ein ungleiches Paar, aber für Researcher und Agenturen wirken sie Wunder.
Was ein Repository für Kundenforschung wirklich ist
Ein Repository für Kundenforschung ist ein zentraler Speicher Ihrer Kundenbelege, der das Projekt überdauert, aus dem er stammt. Es ist kein Pitch-Deck und keine Zusammenfassung, die jemand im Meeting geschrieben hat – es enthält die tatsächlichen Gespräche.
Was Teams meistens Repository nennen, ist ein Ordner voller Research-Berichte – und ein Bericht ist bereits die verdichtete Fassung einer subjektiven Interpretation. Er entsteht für ein bestimmtes Projekt und taugt nicht als einzige Wahrheitsquelle über Ihre Kunden.
Was in ein Research-Repository gehört:
- Kunden- und Nutzerinterviews
- Usability-Tests
- Discovery-Calls und Protokolle von Vertriebsgesprächen
- Churn- und Kündigungsinterviews
- Gespräche im Kundenbeirat
- Onboarding-Gespräche, in denen Studienteilnehmende etwas Brauchbares gesagt haben
Transkription ist das, was all das erst möglich macht. Wenn Sie Audio und Video zuverlässig aufzeichnen und in Text umwandeln, können Sie im interaktiven Transkript nach Stichwörtern mit Zeitstempel suchen. Die Belege bleiben aus mehreren Quellen in Reichweite – Monate, nachdem die Studie abgeschlossen wurde.
Warum ein Transkript-Ordner und Claude allein beide zu kurz greifen
Sie können schon heute ein Meeting-Transkript in Claude einfügen und eine brauchbare Einschätzung bekommen. Für ein einzelnes Interview funktioniert das gut – aber stellen Sie sich vor, Sie müssten 20 Interviews auswerten, die über 3 Monate hinweg aufgezeichnet wurden!
Der manuelle Ablauf sieht so aus: Datei suchen > hochladen > Studienkontext erklären > Analyse starten > beim nächsten Mal von vorn. Claude Projects löst einen Teil davon.
Sie laden die relevanten Dateien einmal als Projektwissen hoch, und benutzerdefinierte Anweisungen tragen Ihr Studiendesign in jeden neuen Chat. Jeder Chat startet mit diesem Kontext, sodass Sie dieselbe Geschichte nicht immer wieder erklären müssen.
Was Claude Projects nicht löst, ist die Menge. Claude arbeitet über einige wenige Interview-Transkripte hinweg gut, bis das Kontextfenster voll ist – ein Repository ist aber darauf ausgelegt, weit darüber hinauszuwachsen.
Genau dafür gibt es das Model Context Protocol. Eine MCP-Verbindung koppelt Ihr Research-Repository direkt an Claude, sodass es die Transkripte dort erreicht, wo sie ohnehin liegen.
Claude Connectors bauen auf diesem Framework auf, und ich zeige Ihnen, wie Sie das einrichten.
Schritt 1: Jedes Kundengespräch an einem Ort erfassen
Bevor Claude nützlich sein kann, müssen die Gespräche irgendwo als Text vorliegen. HappyScribe schafft das auf vier Wegen – je nachdem, wie Sie Ihre Research betreiben.
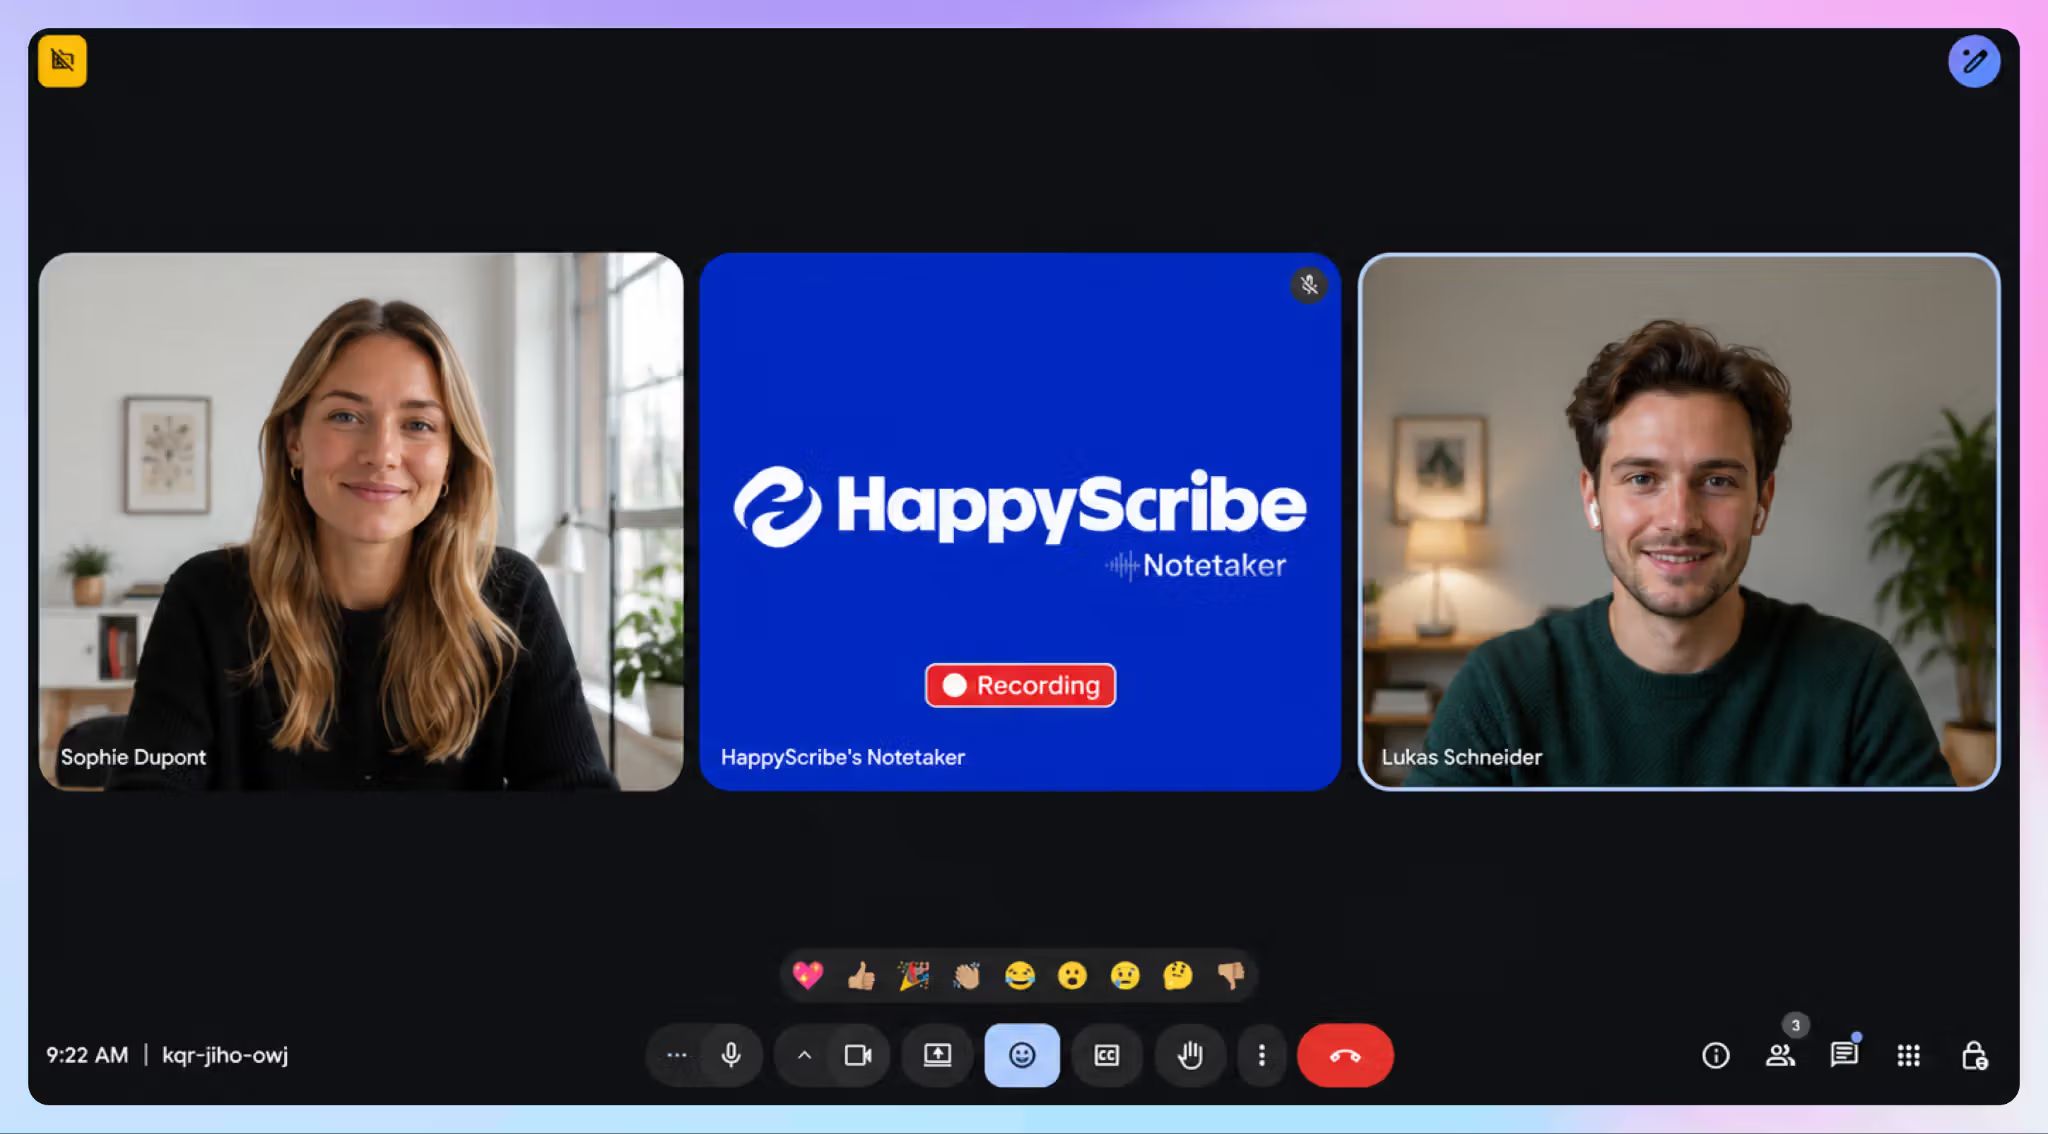
1. Für Remote-Meetings verbinden Sie Ihren Kalender, und der AI Notetaker – Ihr KI-Meeting-Assistent – nimmt an geplanten Meetings in Zoom, Google Meet oder Microsoft Teams teil. Er zeichnet auf, transkribiert und sortiert das Ergebnis von selbst ein.
2. Für Arbeit vor Ort oder spontane Gespräche nehmen Sie direkt mit der HappyScribe Mobile App auf. Alle Feldbesuche und kontextuellen Interviews landen im selben Konto wie Ihre Remote-Meetings.
3. Für den Bestand laden Sie hoch, was Sie bereits haben. Ein neues Repository füllen Sie schnell mit archivierten Interview-Aufnahmen – und genau hier starten Agenturen meistens.
4. Importieren können Sie außerdem aus Google Drive, Box, Wistia, Dropbox, YouTube und Vimeo – damit sind aufgezeichnete Webinare und alles abgedeckt, was Ihnen ein Kunde schickt.
HappyScribe unterstützt mehr als 150 Sprachen und Dialekte, und die automatische Transkription lässt sich auf eine von Menschen geprüfte Transkription hochstufen, wenn die Genauigkeit einen Expertenblick braucht.
Der Sinn dieses Schritts ist einfach: Schluss damit, dass Kundenbelege an unverbundenen Orten liegen bleiben.
Schritt 2: So organisieren, wie Sie später fragen werden
Jetzt liegt ein Stapel Transkripte an einem Ort, aber sie gehören zu verschiedenen Projekten, Zielen und Abteilungen. Der nächste Schritt ist, sie in Ordner zu sortieren, damit Sie Claude auf einen bestimmten Bestand an Belegen ansetzen können statt auf Ihr gesamtes Konto. Und Ordner sind auch fürs Auge angenehmer.
So organisieren Sie Transkripte in HappyScribe in Ordnern:
- Nach Research-Projekt. Onboarding-Research, die Preisstudie, Churn-Interviews, Enterprise-Discovery-Runden usw. Das entspricht dem, wie die Arbeit tatsächlich beauftragt wird.
- Nach Kundensegment. KMU, Mid-Market, Enterprise, Hochschulen, Gesundheitswesen usw. Praktisch, wenn Sie wissen, dass Sie später Gruppen vergleichen wollen.
- Nach Produktbereich. Aktivierung, Zusammenarbeit, Reporting, Abrechnung, Suche – oder wonach auch immer Ihre Roadmap gegliedert ist. Diese Struktur hilft Produktmanagerinnen und Produktmanagern am meisten, wenn sie Monate später mit Fragen kommen.
- Nach Zeitraum. Quartale oder Studienrunden, damit Sie sehen, wie sich dasselbe Muster von einer Runde zur nächsten verschiebt.
Tags ergänzen die Ordner. Sie können sowohl Dateien als auch Ordner taggen und im HappyScribe-Dashboard danach filtern, um schneller zu arbeiten. Bei sehr vielen Dateien bitten Sie einfach Claude darum, Ordner anzulegen und Transkripte zu verschieben.
Erwähnen sollte ich hier, dass Ihre Ordnerberechtigungen aus HappyScribe übernommen werden. Private Ordner bleiben privat, und Unterordner erben, was der übergeordnete Ordner erlaubt – Claude kommt also nicht an Daten, die Sie nicht freigeben wollen.
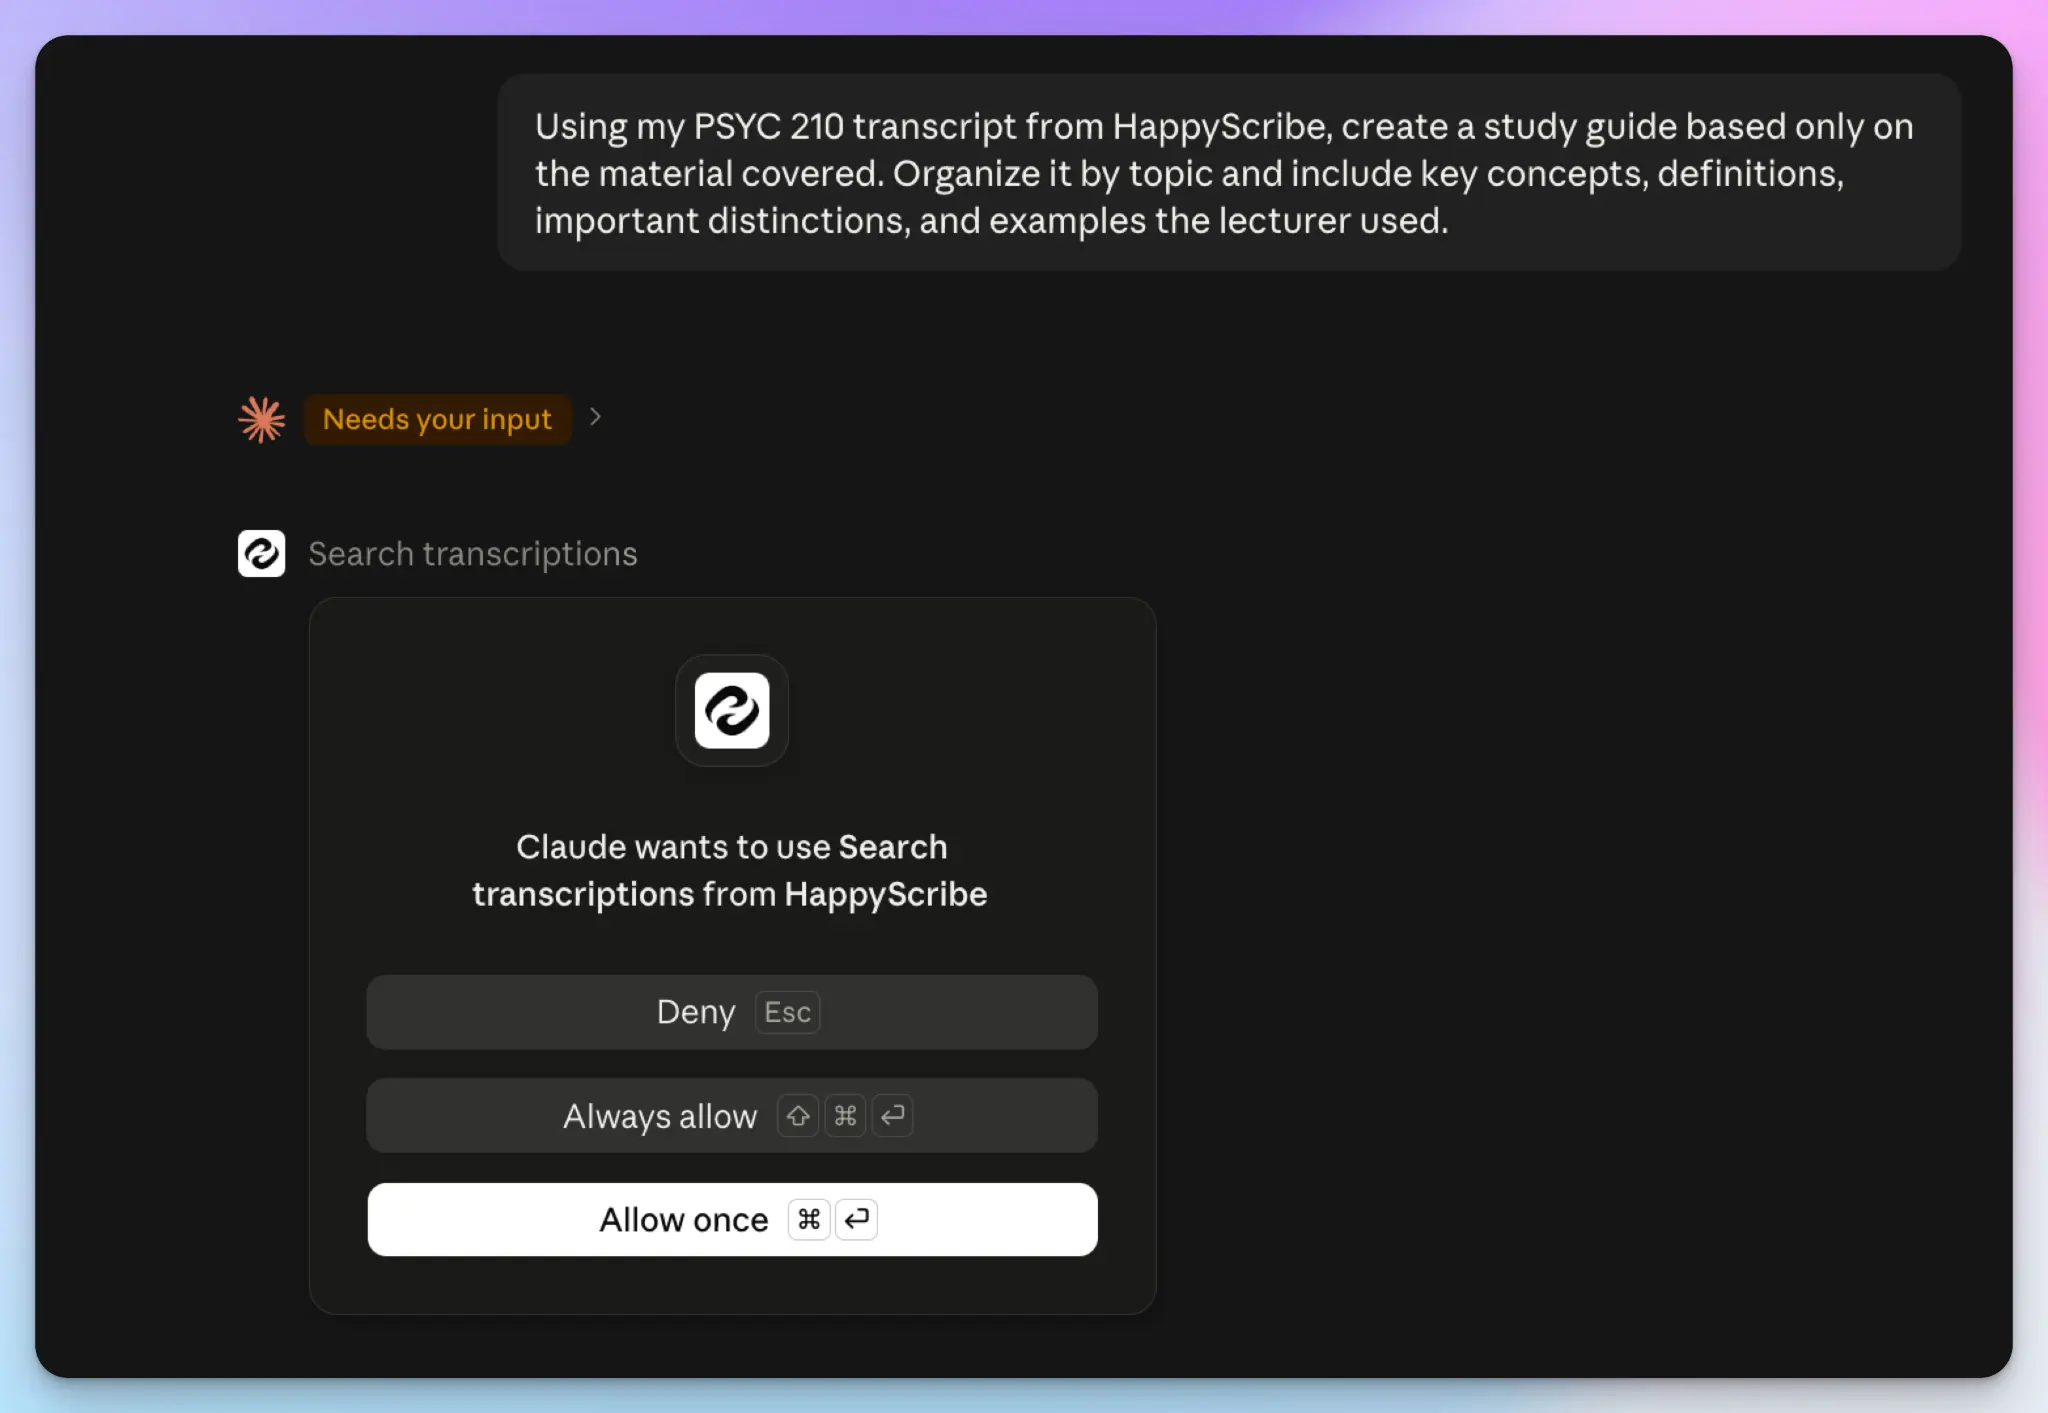
Schritt 3: Das Repository mit Claude verbinden
Das Verbinden dauert ein paar Minuten und muss nur einmal passieren.
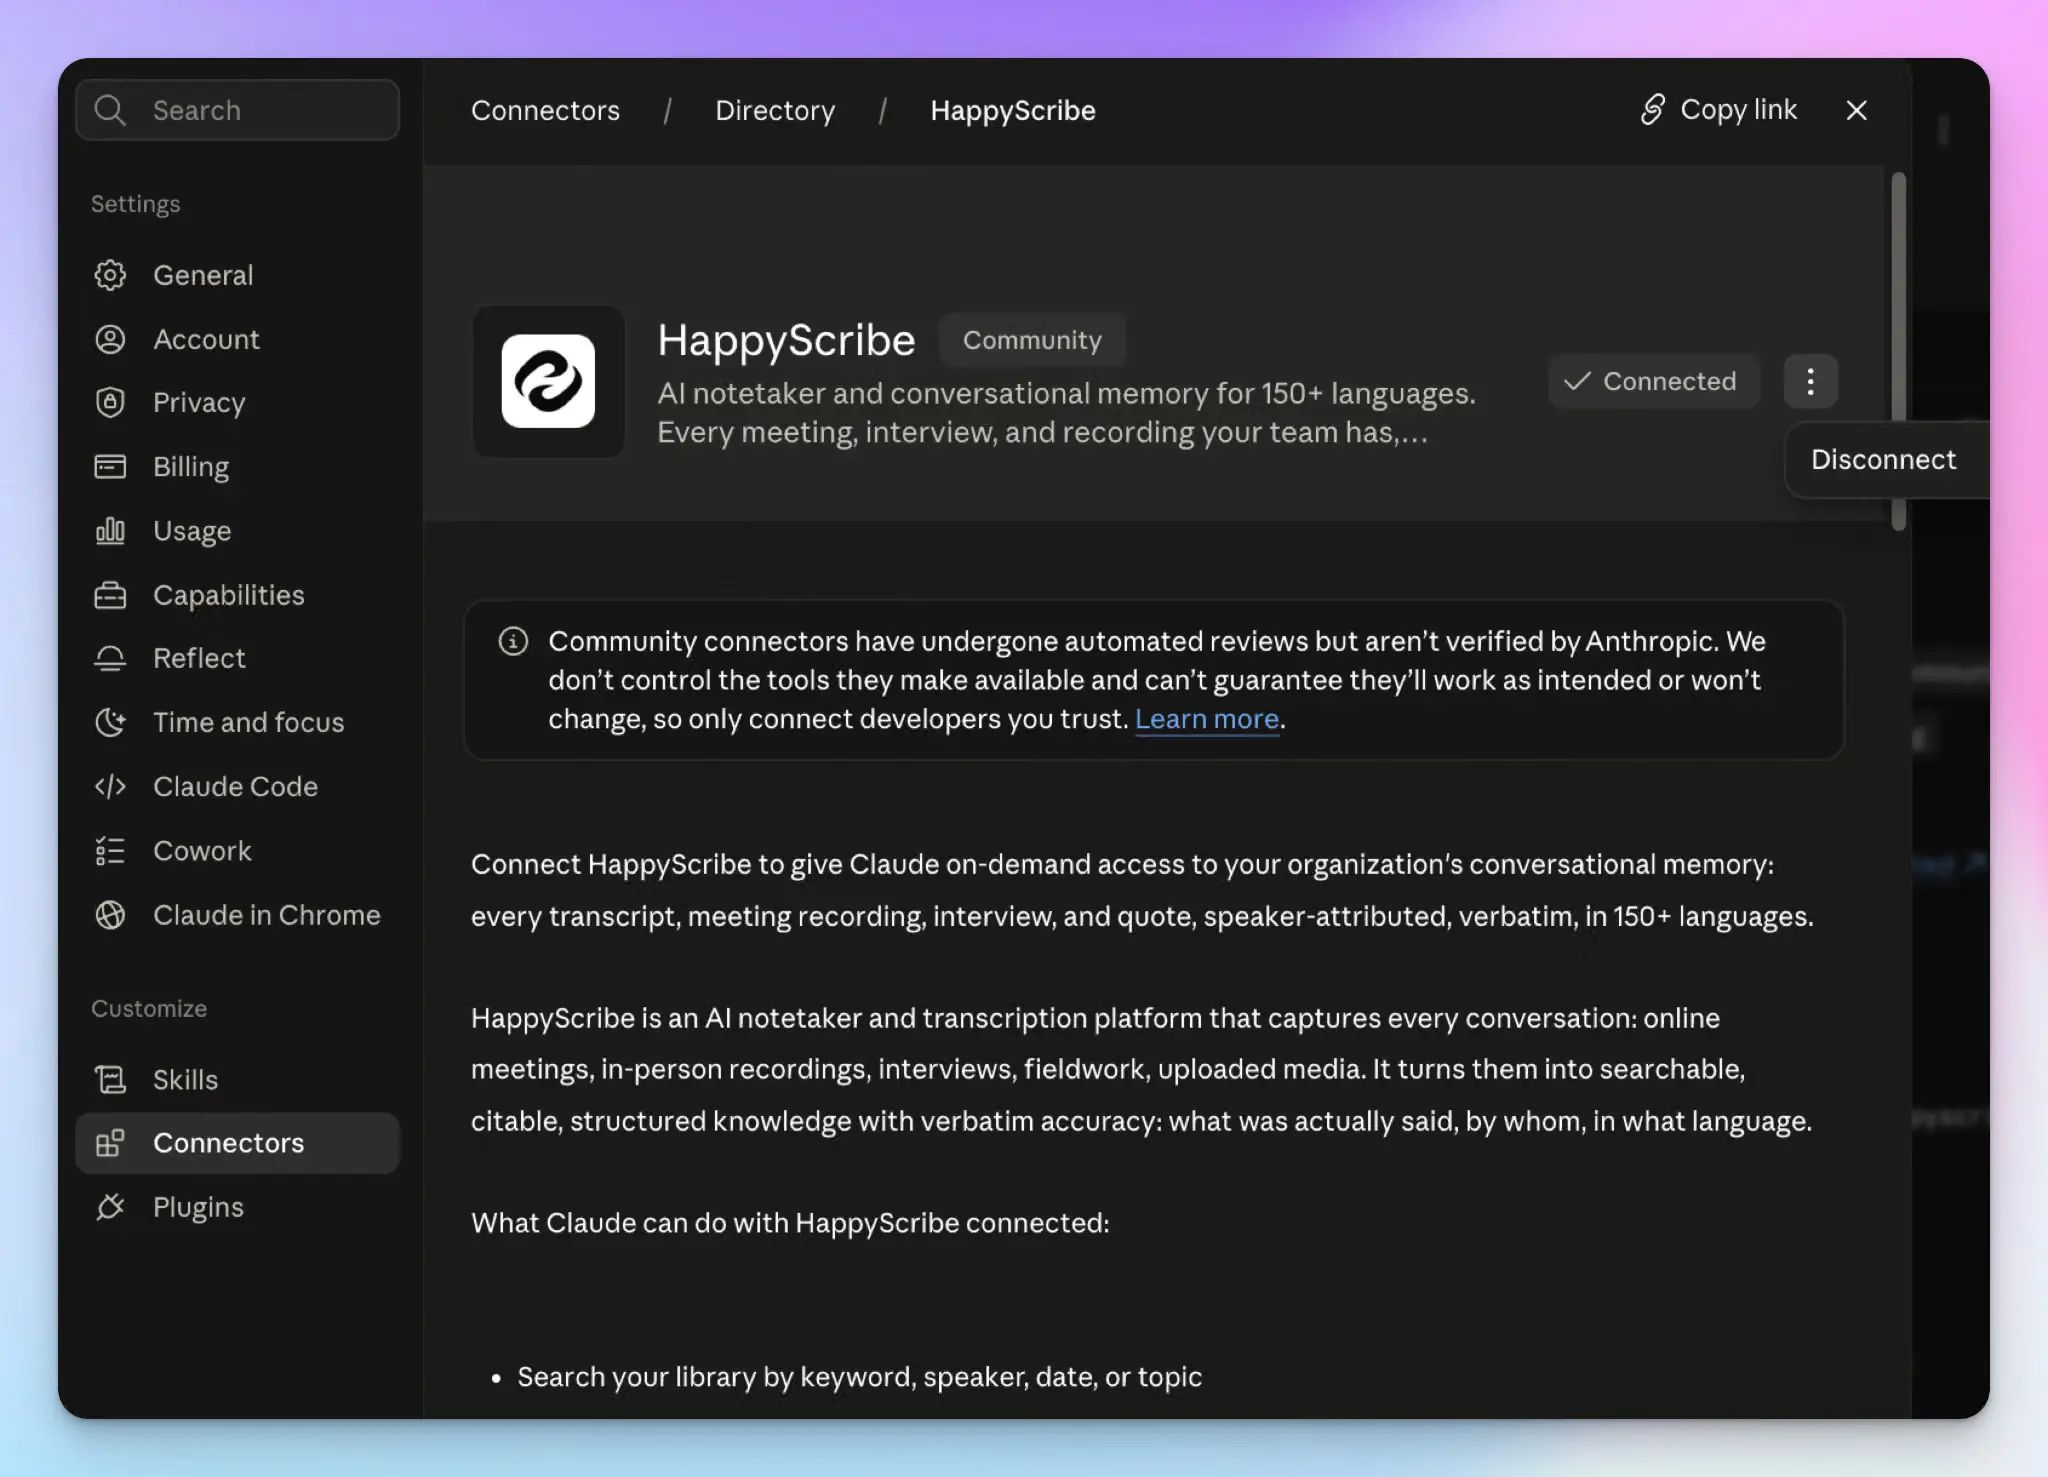
Auf Claude-Seite:
- Klappen Sie die linke Seitenleiste auf und klicken Sie auf Anpassen > Connectors.
- Suchen Sie nach HappyScribe und klicken Sie auf das +-Symbol oder die Schaltfläche „Mit Claude verbinden“.
- Melden Sie sich in Ihrem HappyScribe-Konto an und erteilen Sie den Zugriff.
Sie können auch bei HappyScribe starten. Klicken Sie in der linken Seitenleiste auf Integrationen, suchen Sie die Claude-Karte und klicken Sie auf Verbinden.
Die Claude Desktop App und Claude Code nutzen denselben HappyScribe MCP-Server, den Sie über die Entwicklereinstellungen oder mit einem einzigen Terminal-Befehl hinzufügen. Enterprise-Admins können den Connector für einen gesamten Workspace ausrollen.
Einmal verbunden, greift Claude nur dann auf Ihre Transkripte zu, wenn Sie es verlangen. Nichts wird vorab kopiert, und keine Research-Daten verlassen HappyScribe, bevor ein Prompt sie anfordert.
Hören Sie es von unseren Nutzerinnen und Nutzern, die HappyScribe mit Claude einsetzen:
Ich nutze HappyScribe für alle meine Meetings: Sitzungen aufzeichnen, Notizen machen, Zusammenfassungen bekommen und über den MCP alles mit meinem Claude-Konto verbinden. Ich finde es großartig, dass die Transkripte in meiner Sprache (Bulgarisch) genau sind und mir sehr viel Zeit sparen.
Schritt 4: Fragen über das gesamte Repository stellen
Hier fängt Ihr Repository an, sich auszuzahlen. Statt sich zu merken, in welchem Interview eine bestimmte Aussage fiel, fragen Sie einfach danach. Das sind die Funktionen, die HappyScribe an Claude weitergibt:
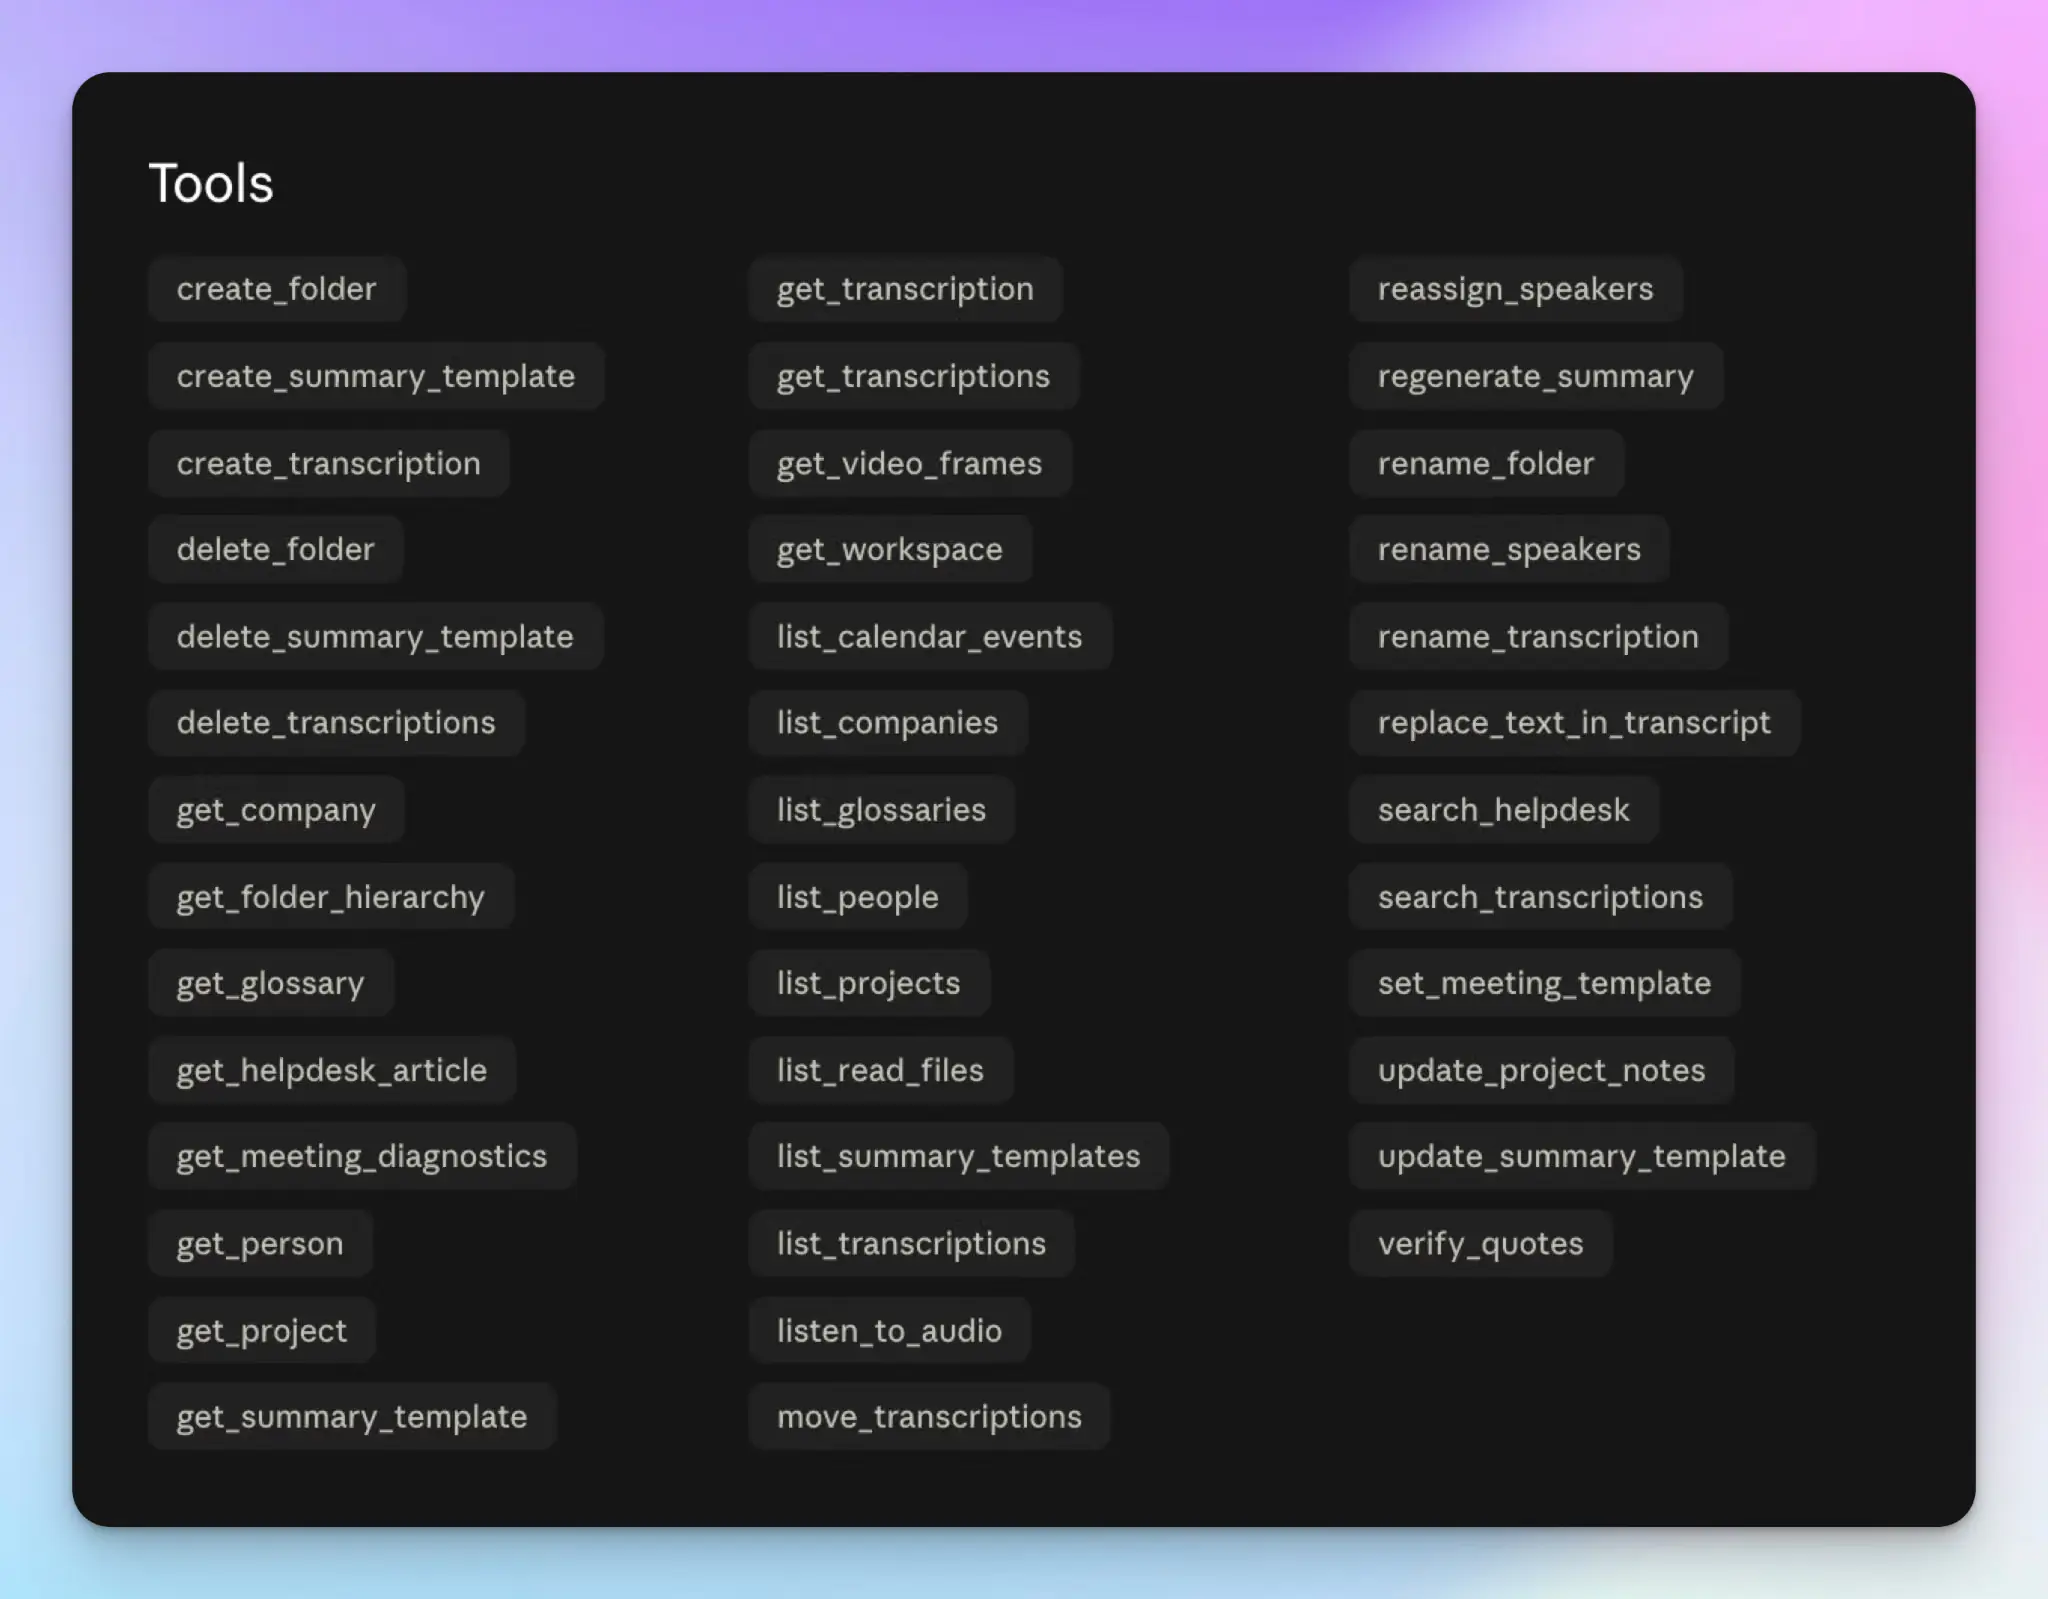
Beginnen Sie mit dem Auffinden. Claude durchsucht Transkriptinhalte so, wie Sie ein Dokument durchsuchen würden, und filtert danach, wer dabei war und wann das Gespräch stattfand:
Finde Interviews, in denen Kunden Schwierigkeiten beim Einrichten ihres Workspace beschrieben haben.
In welchen Gesprächen aus dem letzten Quartal kamen Bedenken zum Preis auf?
Zeig mir alle Sitzungen, in denen Joy M. das Interview geführt hat.
Gehen Sie dann über das reine Finden von Dateien hinaus. Dieselbe Verbindung lässt Claude einen ganzen Ordner lesen und Fragen beantworten, die kein einzelnes Transkript beantworten kann:
Welche Probleme kamen in den Onboarding-Interviews in diesem Ordner in mehr als einer Sitzung vor?
Welche Gründe nannten abgewanderte Kunden für ihre Kündigung?
Welche Einwände tauchten in unseren Discovery-Calls am häufigsten auf?
Für die zweite Gruppe brauchten Produkt- und Kundenteams früher Wochen. Sie mussten Transkripte kodieren, Zitate nach Themen taggen und zählen, wie oft etwas wiederkehrt – alles von Hand. Claude erledigt den ersten Durchgang in Minuten.
Damit lassen sich auch Daten leicht extrahieren. Fragen Sie nach Funktionswünschen als Tabelle mit Teilnehmenden und Sitzungsdatum, und Sie haben etwas, das Sie der Führungskraft geben können.
Nutzerinnen und Nutzer schätzen den Komfort von HappyScribe + Claude:
Die native Claude-Integration über MCP war der Grund, warum wir HappyScribe eingeführt haben – und sie ist schneller zur täglichen Gewohnheit geworden, als ich erwartet hätte. Ich frage Claude per Sprache über meine Kopfhörer beim Spazierengehen, was ich einem Partner im letzten Meeting zugesagt habe: kein Tippen, kein Wühlen in Notizen.
Schritt 5: Themen bilden, ohne die Belege zu verlieren
In derselben Umfrage von User Interviews, die ich eingangs erwähnt habe, gaben 91 % an, dass sie sich um die Genauigkeit der Ergebnisse und um Halluzinationen sorgen. Researcher sind zu Recht nervös bei einem Thema, das plausibel klingt, sich aber auf nichts zurückführen lässt.
Die Lösung: Lassen Sie keine Erkenntnis ohne ihre Belege zirkulieren. Fragen Sie im selben Prompt nach beidem:
Finde die wiederkehrenden Onboarding-Probleme in diesen Interviews. Nenne zu jedem Thema belegende Zitate mit Zeitstempeln und die Teilnehmenden, die es gesagt haben.
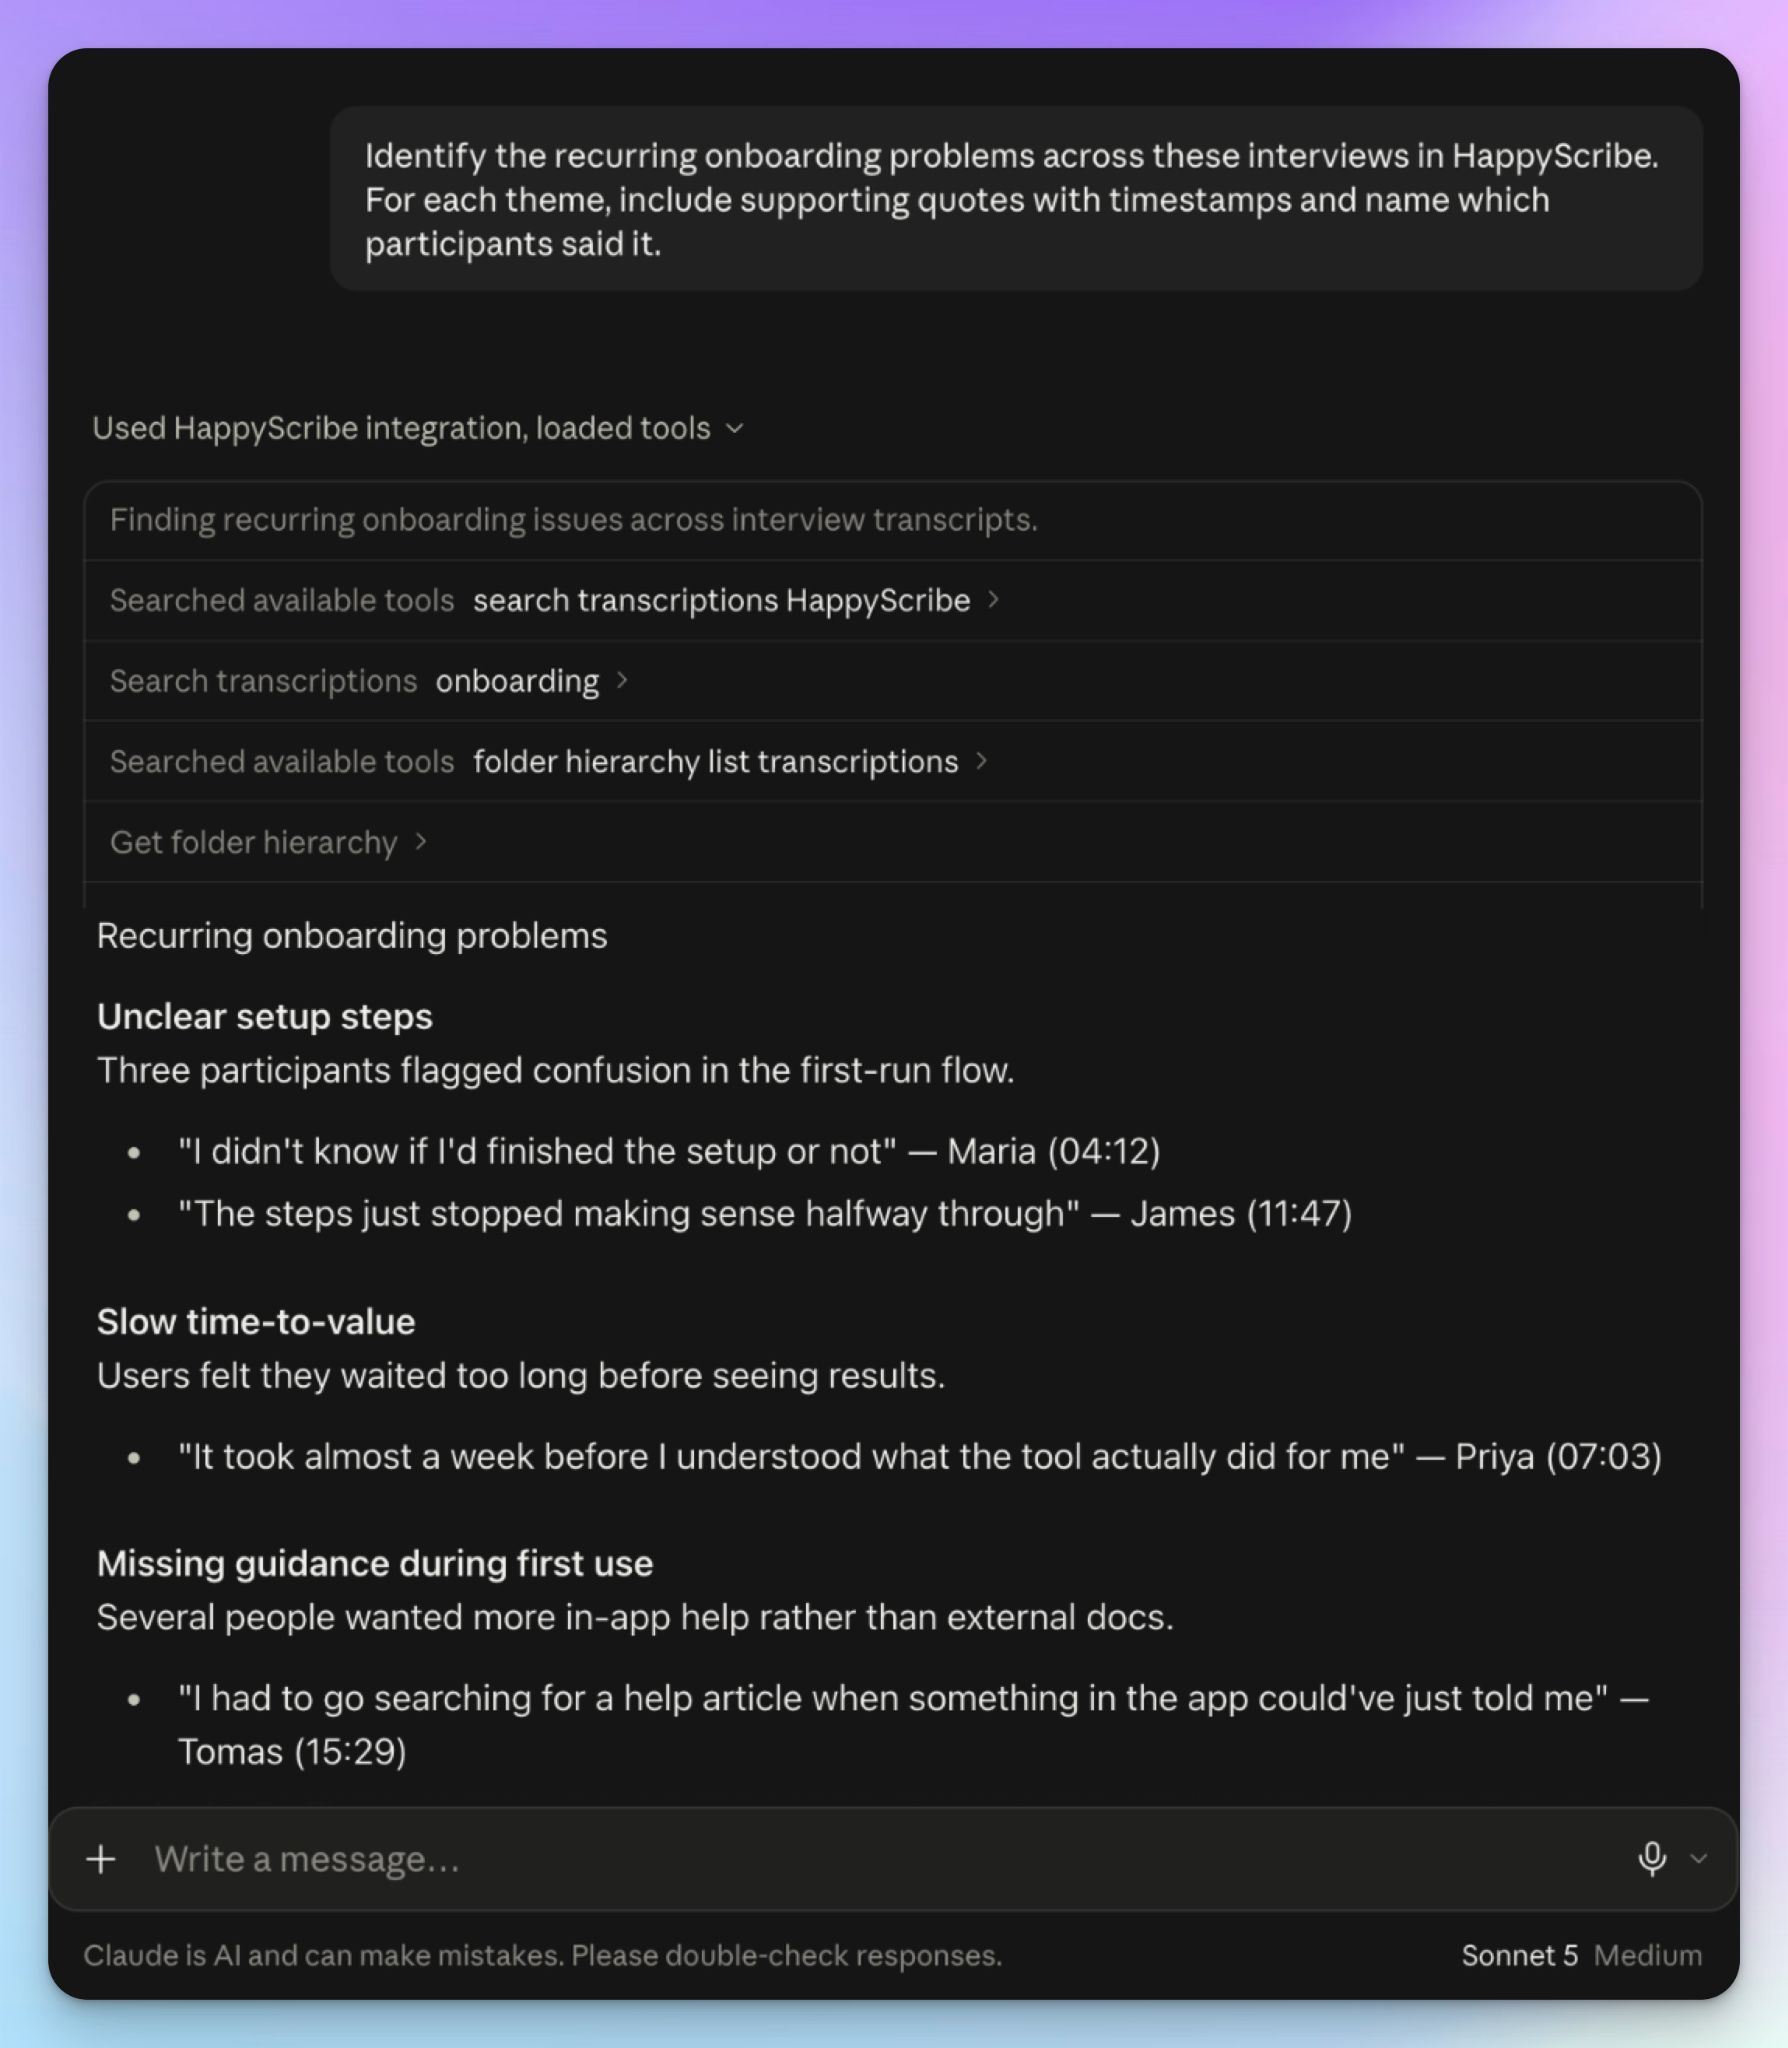
Claude liefert exakte Zitate mit Zeitstempeln und Links zurück in den HappyScribe-Editor – jede Aussage ist also einen Klick von der Prüfung entfernt. Sie hören den Tonfall, das Zögern und die Frage, die dazu geführt hat.
Dann drehen Sie die Schleife: Thema identifizieren > Belege anfordern > Zitat öffnen > prüfen, ob es wirklich das aussagt, was das Thema behauptet.
Der letzte Schritt gehört Ihnen. Claude gruppiert, was ähnlich klingt – und Sie entscheiden, ob zwei Kunden, die von einer „verwirrenden Einrichtung“ sprechen, dasselbe Problem meinen oder zwei verschiedene.
Schritt 6: Geprüfte Erkenntnisse in Ergebnisse überführen
Erst jetzt ergibt es Sinn, Claude überhaupt etwas schreiben zu lassen. Halten Sie die richtige Reihenfolge ein: Frage > Belege > Synthese > Ihre Prüfung > Ergebnisdokument. Wenn Sie direkt zum Ergebnisdokument springen, bekommen Sie geschliffene Prosa auf Basis ungeprüfter Gruppierungen.
Sobald die Erkenntnisse standhalten, liefert dieselbe Verbindung:
- Research-Berichte mit bereits angehängten Zitaten und Zeitstempeln
- Voice-of-Customer-Zusammenfassungen für Teams, die den vollständigen Bericht nicht lesen
- Product-Opportunity-Briefings – gestützt auf das, was Kunden tatsächlich gesagt haben
- Stakeholder-Updates zu genau der Frage, die jemand im Meeting gestellt hat
- Zitatsammlungen für Messaging, Produktseiten oder ein Sales-Deck
Fragen Sie nach dem Format, das Sie brauchen. Weil die Belege bereits an der Quelle hängen, ist das Ergebnis eine Grundlage, auf der sich Entscheidungen treffen lassen.
Fragen, die Sie Ihrem Repository stellen sollten
Mit den Schritten oben läuft das Repository. Hier sind einige Fragen, mit denen Sie am meisten daraus herausholen:
Eine Hypothese an den Belegen prüfen
Teams streiten ständig über Annahmen. Mit einem Repository prüfen Sie eine davon, bevor die Diskussion weiterläuft.
Wir glauben, dass die Komplexität der Einrichtung unsere größte Hürde bei der Aktivierung ist. Was in diesen Interviews stützt das, und was spricht dagegen?
Kundengruppen vergleichen
Wenn Sie immer mit aggregierten Themen vorangehen, konstruieren Sie einen Durchschnittskunden, der Ihrer Nutzerbasis nicht ähnelt.
Wie beschreiben Enterprise-Kunden dieses Problem anders als KMU-Kunden?
Das funktioniert nur, wenn die Unterscheidung in Ihren Ordnern oder in den Aussagen der Teilnehmenden steckt – segmentieren Sie also früh, wenn Sie das später brauchen.
Finden, was dem vorherrschenden Thema widerspricht
Konsens ist leicht zu finden, kann aber auch in die Irre führen. Mit widersprüchlichen Belegen treffen Sie klügere Produktentscheidungen.
Die meisten Teilnehmenden fanden das Onboarding schwierig. Finde die Interviews, die dem widersprechen, und erkläre, was bei diesen Kunden anders war.
Verfolgen, wie sich Feedback über die Zeit verändert hat
Vergleiche die Onboarding-Beschwerden aus Q1 mit unseren jüngsten Interviews. Was ist leiser geworden, und was ist neu?
Das ist der Ertrag dafür, dass Sie die Originalgespräche behalten, statt jede Studie als Einzelfall zu behandeln. Es zeigt Ihnen auch, ob die Verbesserung aus der letzten Runde tatsächlich gewirkt hat.
Einen Kunden über alle Gespräche hinweg verfolgen
HappyScribe baut einen Knowledge Graph der Personen und Unternehmen auf, die in Ihren Transkripten vorkommen – so lässt sich die Historie eines Kunden über einzelne Sitzungen hinweg abrufen.
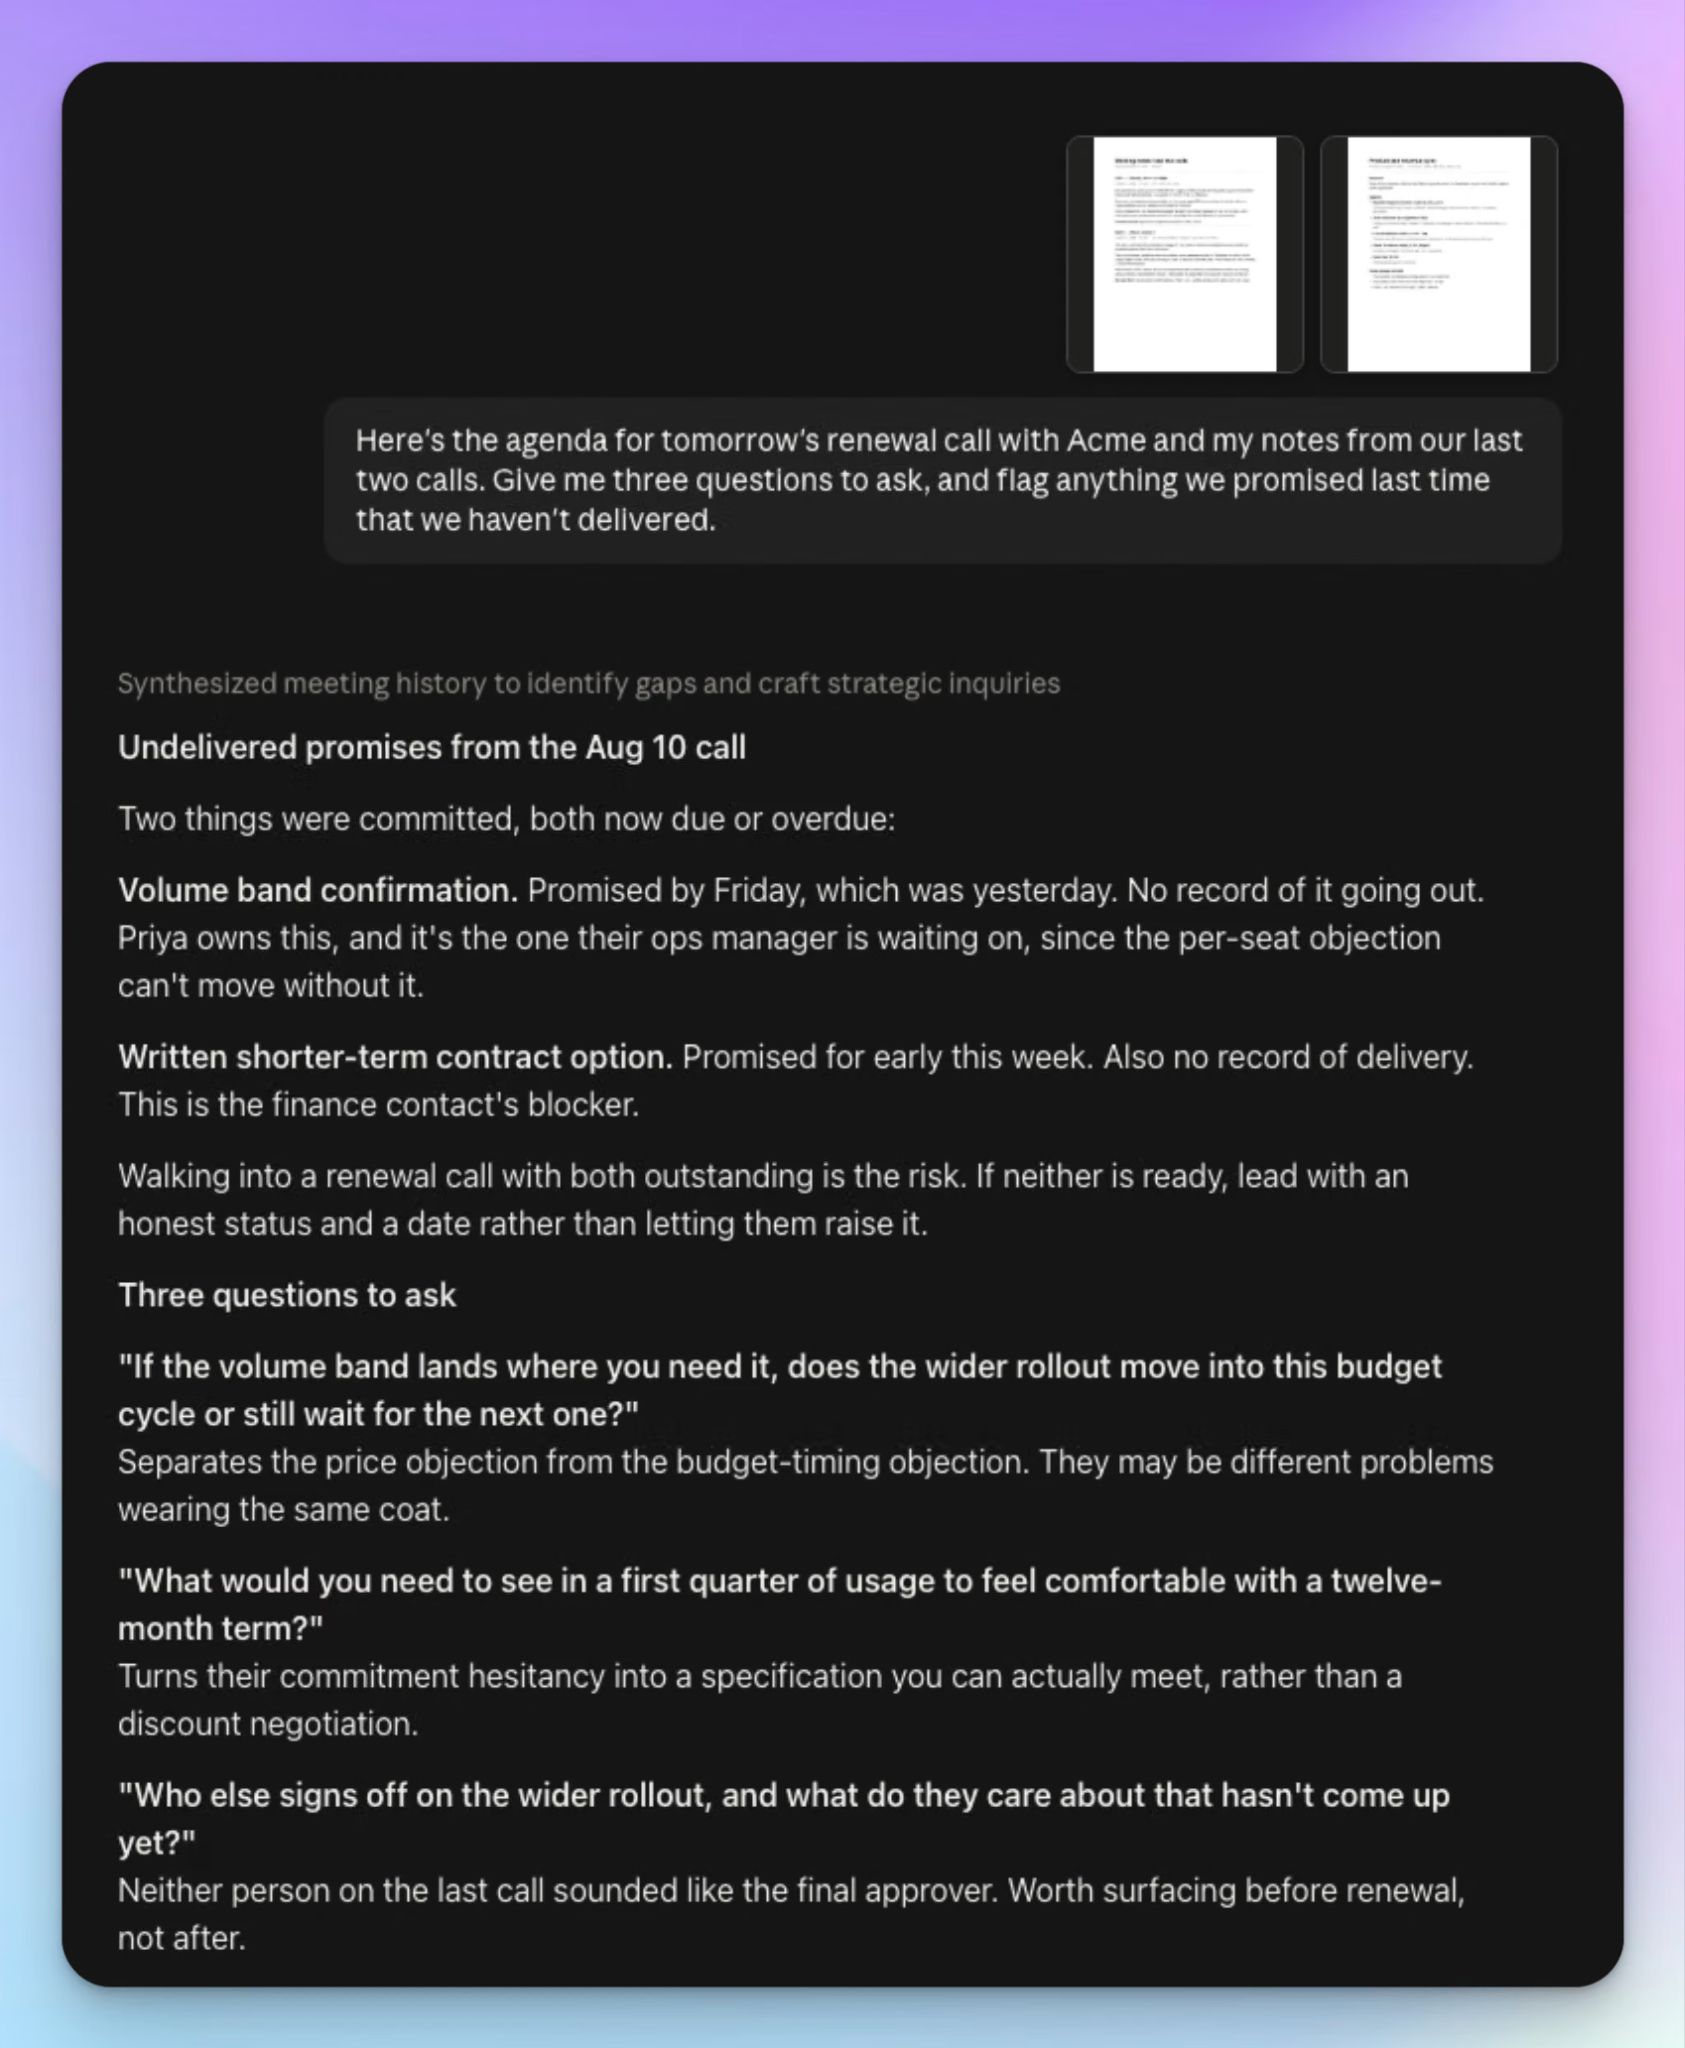
Was hat Acme in all unseren Gesprächen zur Einführung gesagt, und wie haben sich die Prioritäten verschoben?
Nützlich für Verlängerungen und QBRs – auch wenn es ein Weg durch Ihr eigenes Research-Material ist und kein CRM.
Das Repository vertrauenswürdig halten
Weil ein Repository Kundengespräche an einem Ort bündelt, müssen Sie genauer darauf achten, wie Sie damit umgehen.
Holen Sie die Einwilligung im Termin ein, nicht im Nachhinein. Sagen Sie den Teilnehmenden, dass das Gespräch aufgezeichnet und transkribiert wird, und benennen Sie klar, ob ein KI-Assistent für die Auswertung eingesetzt wird.
Achten Sie darauf, was in den Transkripten steckt. Qualitative Forschungsinterviews enthalten Namen, Arbeitgeber, Kontodetails und gelegentlich etwas, das Teilnehmende gar nicht preisgeben wollten. Im Editor von HappyScribe bereinigen Sie das, bevor die Datei Teil des durchsuchbaren Repositorys wird – und anonymisierte Transkripte lassen sich sicherer für einen größeren Kreis öffnen.
HappyScribe arbeitet mit Sicherheit auf Enterprise-Niveau und ist konform mit DSGVO und SOC 2 Type II, dazu kommt Hosting in der EU. Deshalb nutzen Rechtsabteilungen, Hochschulen und Vertriebsteams es für Arbeit, die nicht auf einem allgemeinen Laufwerk liegen darf.
Wenn all das steht, klären Sie die Zugriffsrechte. Nicht jeder, der von den Erkenntnissen profitiert, braucht Zugriff auf die Rohaufnahmen – Ordnerberechtigungen sind das Mittel, um diese Grenze zu ziehen. Enterprise-Admins legen das auf Workspace-Ebene fest.
Ein Repository für Kundenforschung wird mit jedem Zuwachs nützlicher
Jedes Interview, das Sie hinzufügen, macht die nächste Frage leichter zu klären – und nichts davon verlangt, den Kontext neu aufzubauen, wenn eine neue Frage auftaucht. Mit Claude und HappyScribe wird die Markt- und Produktforschung ein Stück angenehmer.
FAQs zum Aufbau eines Repositorys für Kundenforschung mit Claude
Kann Claude mehrere Interview-Transkripte gleichzeitig auswerten?
Ja, aber nicht per Copy-and-paste. Einfügen funktioniert bei einer Handvoll Interviews und bricht danach zusammen – deshalb braucht Claude für große Research-Repositorys MCP-Integrationen. Sobald HappyScribe verbunden ist, setzen Sie Claude auf einen Ordner an, und es durchsucht jedes Transkript darin. Auch die Datenextraktion wird einfacher: Fragen Sie nach den Problemen, die Kunden am häufigsten genannt haben, als Tabelle mit Teilnehmenden und Sitzungsdatum in jeder Zeile.
Brauche ich Claude Code für ein Repository für Kundenforschung?
Nein. Die meisten Researcher brauchen es nie. Der Connector übernimmt Suche und Synthese von allein. Claude Code hilft, wenn Sie einen wiederholbaren Workflow statt einer einmaligen Antwort wollen – und Sie müssen dafür nicht entwickeln können. Beim Vibe Coding beschreiben Sie in normaler Sprache, was Sie möchten, und Claude schreibt das Skript. Es führt dann mehrstufige Aufgaben eigenständig auf Ihrem Rechner aus und kann strukturierte CSV-Dateien mit Konfidenzwerten für jede extrahierte Erkenntnis ausgeben. Das ist der größte Hebel: die Extraktion einmal coden und bei der nächsten Interviewrunde erneut laufen lassen.
Was ist der Unterschied zwischen Claude Projects und dem HappyScribe-Connector?
Projects geben Ihnen dauerhaften Kontext innerhalb eines Projekts. Sie laden Dateien einmal hoch, und Projektanweisungen tragen Ihr Studiendesign und Ihre Einschlusskriterien in jeden neuen Chat – Sie erklären den Hintergrund also nicht immer wieder. Sie schieben aber weiterhin Dateien hinein, ob vom Desktop oder aus Google Drive, und ein einzelnes Gespräch fasst nur begrenzt viel. Der Connector spart diesen Schritt, weil er die Transkripte dort erreicht, wo sie ohnehin liegen.
Kann Claude Cowork bei der Research-Synthese helfen?
Ja. Cowork ist für Wissensarbeit mit mehrstufigen Aufgaben gebaut, nicht für eine einzelne Frage. Setzen Sie Cowork auf einen Studienordner an, und es zieht die Themen heraus, sammelt die belegenden Zitate und macht daraus in einem Durchgang Foliensätze oder einen schriftlichen Readout. Für die Synthese selbst nutzen Sie Claude Opus – dort zählt das Abwägen widersprüchlicher Belege am meisten.
Wie verhindert man, dass Claude bei der Research-Analyse Zitate erfindet?
Fragen Sie im selben Prompt nach der Erkenntnis und nach den Belegen. Verlangen Sie zu jedem Thema belegende Zitate mit Zeitstempeln, öffnen Sie ein oder zwei davon und prüfen Sie, ob sie das aussagen, was das Thema behauptet. Das gilt genauso für Kundeninterviews, eine Literaturrecherche oder ein gemeinsames Archiv, das Ihre Forschungsgruppe pflegt. KI-Tools gruppieren, was ähnlich klingt – ob das stimmt, entscheiden Sie. Dieser Faktencheck macht aus einer Ausgabe umsetzbare Erkenntnisse.

Biplab Mazumder
Biplab is a content marketer and writer who helps high-growth brands scale content visibility across AI search channels. His works have been published in HubSpot, Freshworks, Atlassian, SurferSEO, etc. When he's not planning content strategy, he's testing AI content workflows and use cases.